Promo Margin Lab
▶ Статический рендер дашборда — собран из тех же SQL-мартов, что и живой Superset; в подвале подписано, что это рендер
Ситуация
Промо в офлайн-ритейле почти всегда измеряют одним числом: насколько выросли продажи относительно среднего допериода. Этого числа недостаточно для решения, потому что скидка — это расход, часть лифта приходит из будущих недель, часть забирается у соседних SKU, а маржа может двигаться в другую сторону от выручки.
Продукт, ради которого делался кейс, — система моделирования промо до запуска: она должна отвечать, какая глубина и какой набор SKU дадут лучший результат с учётом ограничений. Аналитик в такой команде отвечает не за модель, а за то, чтобы эффект был измерен корректно и переведён в деньги.
Задача
От меня требовалось построить контур измерения и решения: контрфактуал, который не врёт, бухгалтерию лифта в рублях, P&L акции, потолок глубины по категориям, дизайн теста, метрику качества модели и аллокацию бюджета — и на каждом шаге показать, где оценка может ошибиться.
Действия
Панель с известной правдой
561 600 ячеек: 120 магазинов × 60 SKU × 78 недель, три формата, шесть категорий с маржой 12–35%. Промо назначается не случайно: вероятность растёт, когда последние три недели продажи слабые. Генератор хранит восемь компонент правды — базу, лифт, pantry, каннибализацию, halo, кросс-формат, шум и явный residual от клиппинга, — и feature_columns() падает, если хоть одна truth_* попала в признаки.
Цена и глубина подтягиваются as-of join’ом по версии цены, действовавшей в неделю факта: join по store_id + sku_id размножил бы строки и взял не ту цену.
Контрфактуал
Три оценщика на одних и тех же промо: среднее допериода, лог-линейный прогноз с эффектами магазина и SKU, сезонностью и чистой историей без промо-недель, и DiD по непромо-магазинам того же SKU и формата.
Наивная база занижает лифт на −15.6%: среднее за четыре недели отстаёт от провала спроса, на который отреагировал менеджер. Прогноз ошибается на −0.9%, WAPE падает с 12.1% до 7.7%. DiD не спасает: конфаундер идиосинкратичен, контрольные магазины его не разделяют.
Бухгалтерия лифта
Ledger считается по волнам (магазин × неделя × категория), чтобы непромо-ячейка атрибутировалась ровно один раз. Сверка с оракулом: own-лифт −0.9%, каннибализация −6.0%, halo +5.7%, net +1.5%. Halo перекрывает каннибализацию: net-лифт на 3.8% выше own.
Маржа и глубина
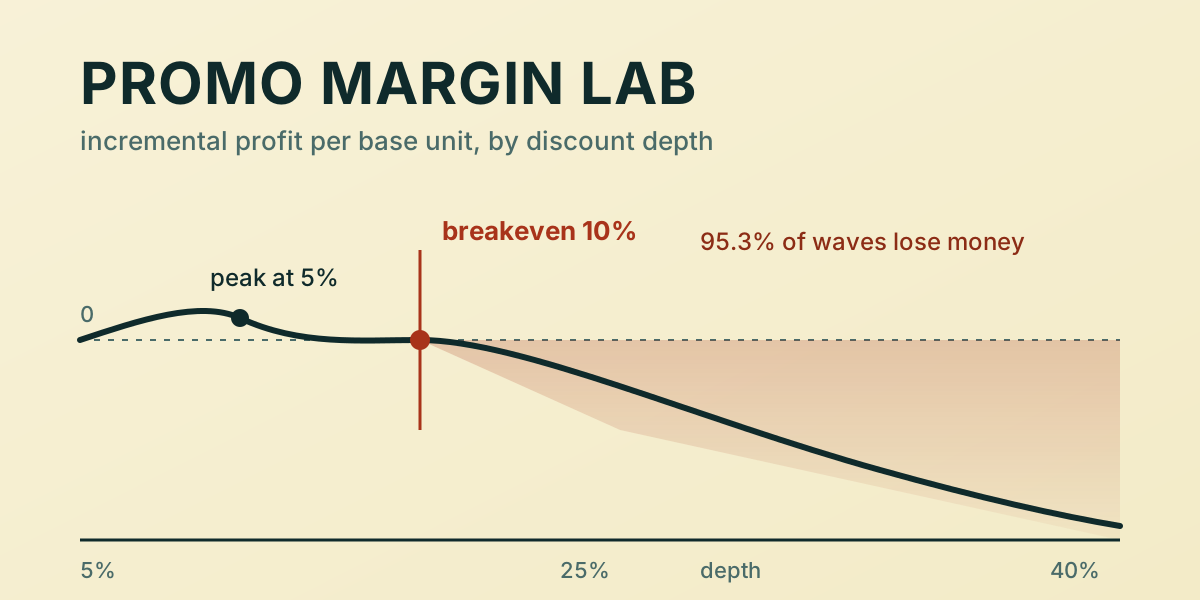
P&L акции: выручка +70.5 млн ₽, скидка 60.0 млн ₽, supplier funding +15.6 млн ₽, инкрементальная прибыль −17.6 млн ₽. Убыточны 95.3% волн, медиана −1 542 ₽. Кривая отклика m(d) = A·(1 − e^(−k·d)) даёт breakeven-глубину: non-food 20.5%, bakery и grocery 10.0%, drinks 4.5%, dairy 2.5%, frozen 2.0% — при фактической средней 25.4%.
Тест
Кластерный дизайн: магазин — единица рандомизации, исход — инкрементальная маржа на store-week. ICC 0.138, MDE 612 ₽ на store-week. На 1 000 пустых сплитов ложноположительных 4.7%, мощность при MDE 77.8%, покрытие CI 95.0%. Классический switchback с общим моментом переключения отвергал 100% под нулём — недельные эффекты съедали лечение; фаза на магазин и two-way demeaning дают 4.0% и восстанавливают carryover 0.5 как 0.49.
Модель и политика
Модель предсказывает инкрементальную маржу на ячейку: R² 0.925, Qini 0.963 [0.958; 0.967], наклон калибровки 1.10. При ёмкости 20% отбор по скору теряет −55 396 ₽; порог «скор > 0» зарабатывает +54 361 ₽ на 285 ячейках; оракул с тем же правилом — +98 280 ₽. Разница между порогом и ранжированием +109 757 ₽, CI [97 505; 121 569].
Аллокация
Одна плановая неделя, 4 756 кандидатов после правила шести недель, глубина 5–40% с потолком категории. На бюджете 450.7 тыс ₽: оптимизатор +222 301 ₽, top-15% +147 472 ₽, случайный +21 460 ₽. Blanket 15% по всем кандидатам теряет −772 224 ₽ на 4.51 млн. Greedy совпадает с brute force на малом экземпляре.
На свободном бюджете 2.25 млн ₽ связывает не деньги, а потолок: оптимизатор расходует 487 тыс ₽ и даёт +223 645 ₽ на 1 829 ячейках, оставляя 1.77 млн ₽ неизрасходованными, а top-15% приходит к тем же ~+225 836 ₽, но за 1.27 млн ₽. Бюджет перестаёт быть решением, как только глубина ограничена.
Superset и Spark
Четыре SQL-марта и SQLite-база. Спецификация описывает три дашборда, а живой инстанс провижинится в один дашборд «Promo Margin Lab» с четырьмя чартами в сетке 2×2 — расхождение подписано, а не спрятано. Статический рендер собран из тех же запросов и помечен в подвале как рендер, а не как живой Superset.
PySpark-джоб (4.2.0, локальный Java 25) сверяет агрегат с pandas на 10 магазинах и 780 строках store-week: максимальное расхождение 0.0 по шести метрикам, ни одной строки с пропущенной стороной; в сгенерированном плане видны broadcast join, window и shuffle. На масштабе 16.6 млн строк джоб материализует 166 тыс. строк за 14.1 с на local[4]. Это проверка корректности на одной JVM, а не замер пропускной способности кластера — так и записано в артефакте reports/spark_parity.json.
Воспроизводимость
Одна точка входа — python run.py --stage all со стадиями data, panel, baseline, ledger, experiment, response, allocation, marts, spark. Профиль --fast считает панель в девять раз меньше (40 магазинов вместо 120), пишет артефакты с суффиксом _fast и никогда не перезаписывает headline-числа. 83 теста, включая сверку Spark с pandas и проверку, что колонки truth_* не попали в признаки.
Результат
Измерение меняет знак решения. Наивная база занижает лифт на −15.6%, прогноз — на −0.9%: разница в смещении 17.7×, и она объясняет, почему «промо сработало» и «промо заработало» — разные утверждения.
В деньгах промо даёт +70.5 млн ₽ выручки и −17.6 млн ₽ инкрементальной прибыли. Убыточны 95.3% волн при медиане −1 542 ₽. Причина не в лифте: halo перекрывает каннибализацию, net-лифт выше own на 3.8%, но скидка платится и за те юниты, которые продались бы по полной цене.
Потолок глубины — 2.0–20.5% по категориям, фактическая средняя глубина 25.4%: ограничение нарушено во всех шести категориях, включая non-food, где 30.0% факта против 20.5% потолка. Дизайн теста даёт MDE 612 ₽ на store-week при ложноположительных 4.7% и мощности 77.8%.
Qini 0.963 не спасает от плохого решения: ранжирование теряет −55 396 ₽, калиброванный порог зарабатывает +54 361 ₽, разница +109 757 ₽. Оптимизатор на том же бюджете даёт +222 301 ₽ против +147 472 ₽ у top-15% и +21 460 ₽ у случайного.
Решение
Рекомендация — не продолжать в текущей конфигурации: держать глубину на потолке категории и финансировать только ячейки с положительной ожидаемой маржой, то есть 3.7% кандидатов, а не весь каталог. Причина не в модели, а в экономике: при фактической глубине 25.4% против потолка 2.0–20.5% скидка съедает маржу быстрее, чем лифт её возвращает.
Что могло бы это изменить: ступенчатый funding от поставщиков (в данных ставка плоская, поэтому не смоделирован), другая эластичность (при множителе 0.85 отбор меняется на 12%, прибыль падает до 150 тыс ₽; при 1.15 — 9% и 302 тыс ₽) и более точный тест: MDE 612 ₽ на store-week слишком грубый, чтобы различать политики, а у switchback SE около 31 ₽.
Ограничения
Данные синтетические: это свойство, а не скидка — правда известна, поэтому оценщик можно сверить с оракулом. Но реальные промо-решения требуют реальных данных: внешняя валидация на публичном датасете не сделана.
Supplier-тиры не смоделированы: в генераторе плоская ставка funding, и тарифная сетка была бы выдуманным допущением. Один плановая неделя — не сезон.
Docker Hub из среды сборки недоступен, поэтому Superset поднят без Docker — Python 3.11 и закреплённые зависимости. Живой инстанс проверен: SQL Lab возвращает те же −17.6 млн ₽ и 9 053 волны, что ledger; экспорт ассетов лежит в репозитории.
Документация
- PRD кейса — требования и acceptance criteria, включая честные отказы.
docs/data-contract.md— схемы, формулы и гарантированное тождество компонент.docs/metric-definitions.md— каждое число со своим знаменателем.docs/experiment-design.md— pre-registration: единица, MDE, план анализа, угрозы валидности.docs/decision-memo.md— решение по глубине и его цена.reports/superset/dashboard.html— статический рендер;superset/README.md— как поднять живой стек.
Частые вопросы
Почему промо убыточно, если выручка растёт?
Скидка платится и за юниты, которые продались бы по полной цене. При средней глубине 25.4% и марже 12–35% инкрементальная прибыль отрицательна в 95.3% волн, хотя выручка +70.5 млн ₽.
Зачем синтетические данные?
В генератор заложена известная правда: база, лифт, каннибализация, halo и pantry-эффект. Поэтому оценщик можно сверить с оракулом, а не с рассказом; net-лифт сходится с оракулом на +1.5%.
Почему порог лучше Qini?
При ёмкости 20% отбор по скору теряет −55 396 ₽, а порог «только положительная ожидаемая маржа» зарабатывает +54 361 ₽, потратив бюджет на 3.7% ячеек.