Python Analytics Playground
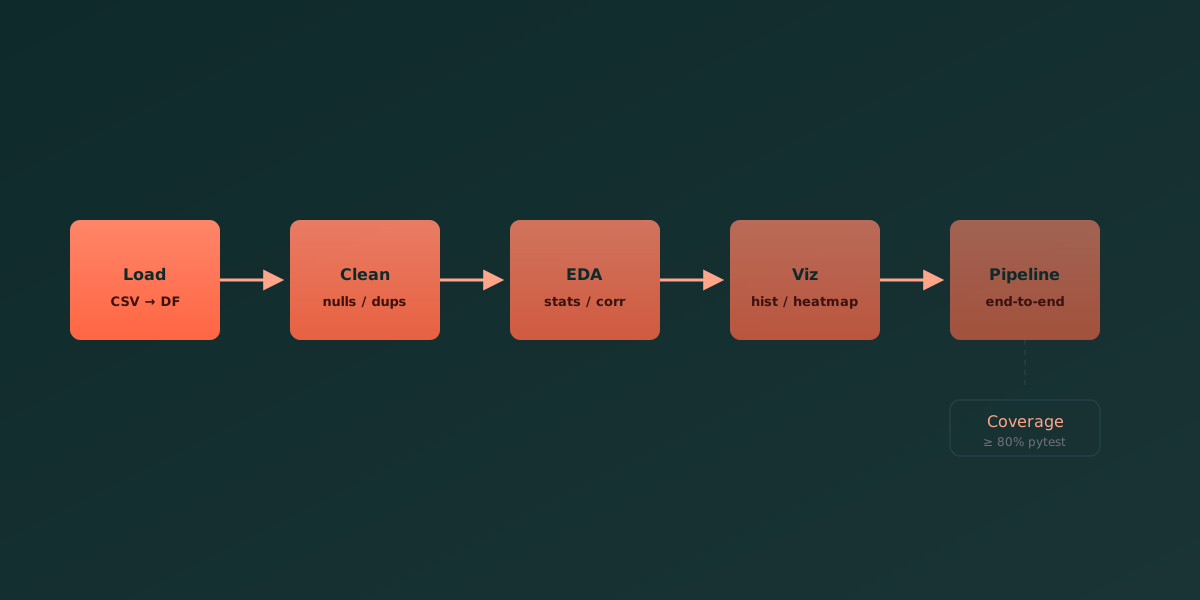
▶ Схема потока данных — самодостаточный HTML, открывается в браузере — без установки и сборки
Ситуация
В продуктовой аналитике большая часть задач начинается одинаково: загрузить выгрузку, почистить, посмотреть распределения и корреляции, показать графики. Этот проект превращает рутину в переиспользуемые модули — чтобы каждый новый анализ стартовал не с нуля, а с проверенной заготовки с тестами, которую можно отдавать коллегам и не бояться сломать.
Задача
От меня требовалось вынести общую часть в модули, которые можно передать коллеге и не бояться сломать при следующем изменении.
Действия
Структура пакета (src/python_analytics/):
load.py(REQ-002) — загрузка CSV в DataFrame с базовыми проверками.clean.py(REQ-003) — пропуски, дубликаты, приведение типов.eda.py(REQ-004) — описательные статистики, пропуски, корреляции.viz.py(REQ-005) — гистограммы, тепловые карты корреляций.pipeline.py(REQ-006) — end-to-end пайплайн, запускаемый какpython -m python_analytics.segment.py— value-сегменты, возрастные когорты и Pareto вместо RFM: данные cross-sectional, без истории транзакций.report.py— сборка markdown-отчёта из EDA- и viz-результатов.
Каждый модуль закрывает отдельное требование из PRD (docs/prd.md), а 34 теста в tests/ проверяют ровно эти требования — покрытие ≥80%.
Запуск
uv sync --all-groups
uv run pytest                          # тесты + покрытие (≥80%)
uv run python -m python_analytics      # end-to-end пайплайн
Результат
Ключевое отличие от разовых аналитических скриптов — структура и проверяемость: модули маленькие и решают одну задачу, требования задокументированы в PRD, а тесты держат покрытие ≥80%. Инструмент можно отдавать коллегам и дорабатывать, не боясь сломать существующее поведение.
Ограничения
Пайплайн рассчитан на табличные CSV и базовый EDA-набор — это не фреймворк для произвольных пайплайнов. Покрытие ≥80% относится к модулям пакета, а не к пользовательским анализам на его основе.