ML Fundamentals — scikit-learn Pipeline
▶ Схема потока данных — самодостаточный HTML, открывается в браузере — без установки и сборки
Ситуация
Вся дальнейшая ML-работа — регрессия, классификация, кластеризация — стоит на предобработке. Если тест протекает в обучение или пропуски обрабатываются руками, любая модель выше по стеку обесценена, а результат не воспроизводится на другой машине.
Курс Machine Learning A-Z задаёт структуру, но его код (sklearn.cross_validation, Imputer, OneHotEncoder(categorical_features=)) удалён из scikit-learn начиная с 0.22 — его нужно перенести на современный API.
Задача
От меня требовалось собрать предобработку корректно с точки зрения современного scikit-learn: без утечки теста в обучение, без опоры на случайный сид и с воспроизводимым результатом на каждом шаге конвейера.
Действия
Предобработка
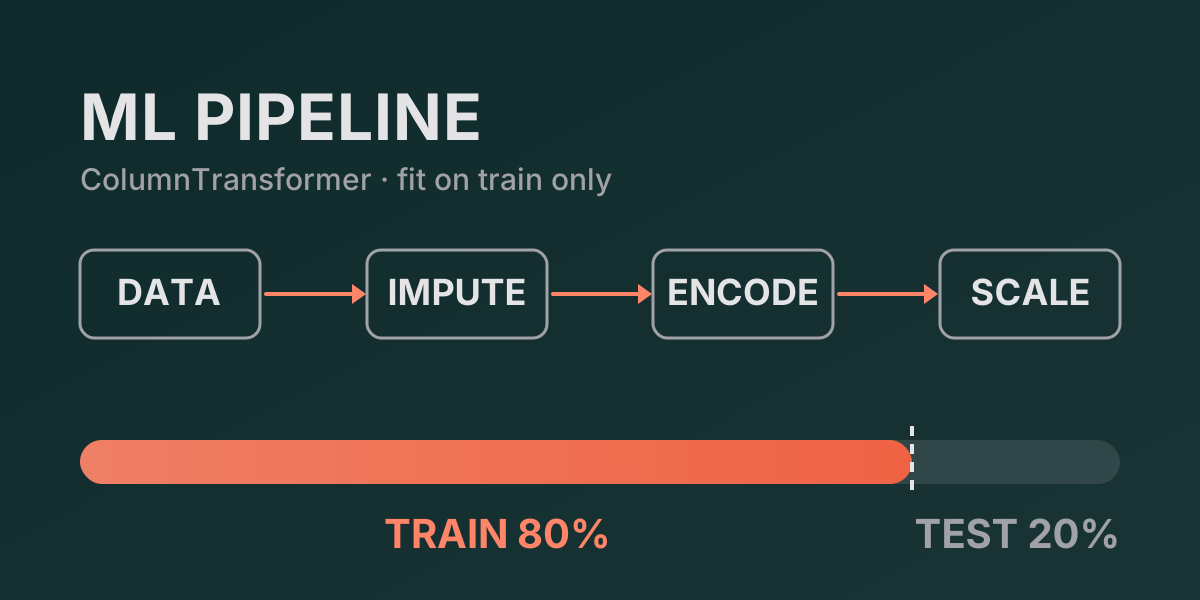
python/data_preprocessing.py строит один ColumnTransformer на Data.csv:
- Пропуски — среднее через
SimpleImputer. - Категории —
OneHotEncoderдля признаков иLabelEncoderдля таргета. - Сплит — детерминированный: строки стабильно сортируются по
(Country, Age), каждая пятая уходит в тест, без случайного сида. - Масштабирование —
StandardScalerтолько по числовым колонкам.
Весь трансформер обучается только на трейне, так что информация из теста не протекает в предобработку.
Датасеты и EDA
python/generate_dummy_data.py — детерминированный генератор (с сидом RNG) дополнительных датасетов, по одному на этап конвейера:
| Файл | Строк | Этап конвейера |
|---|---|---|
Data_large.csv |
400 | расширенная предобработка |
Salary_Data_large.csv |
300 | простая линейная регрессия |
Housing_Data.csv / .sql |
500 | множественная регрессия |
Customer_Churn.csv / .json |
800 | классификация |
python/eda_plots.py рисует графики для каждого датасета в output/ — одна фигура на датасет плюс сводный dashboard.png, всё в едином стиле dark_background, OO-matplotlib, 300 dpi.
Запуск
pip install -r requirements.txt

cd python
python3 data_preprocessing.py        # печатает Train: (8, 5), Test: (2, 5)
python3 generate_dummy_data.py       # синтетические датасеты

cd ..
python python/eda_plots.py           # графики в output/
Результат
Итог — корректный и воспроизводимый конвейер предобработки, а не модель: тест не течёт в обучение, а сплит повторяется на любой машине.
- Предобработка — один пайплайн, обученный только на трейне: тест не протекает в обучение.
- Сплит воспроизводим без сида: на
Data.csv— Train(8, 5), Test(2, 5). - Шесть курсовых датасетов плюс четыре синтетических (400, 300, 500 и 800 строк).
- EDA-графики по каждому датасету в едином
dark_background, 300 dpi, плюс сводныйdashboard.png. - Код перенесён на современный scikit-learn API; pytest-тесты держат конвейер запускаемым.
Ограничения
Это учебный проект: датасеты курсовые и синтетические, а не продовые. Цель — корректность конвейера и воспроизводимость, а не качество модели на реальных данных.