Ликвидность классифайда — аудит измеримости
Ситуация
Классифайд, где сделка закрывается вне платформы. Платформа логирует поиски, показы, просмотры, контакты и снятия объявлений — но никогда не логирует саму продажу. Ликвидность считается по самоотчёту продавца: removal_reason == "sold".
Такой прокси выглядит разумно, пока его никто не проверял. Продавец может снять объявление из-за цены, конкурента или просто передумать, и метрика запишет это как продажу. Вопрос не в том, ошибается ли прокси, а в том, насколько и одинаково ли ошибается по категориям.
Задача
Мне нужно было измерить расхождение прокси с посаженной истиной по категориям и проверить, выдерживает ли решение о платной видимости такую поправку.
Действия
Синтетическая база с ответом. Сгенерировал 6 000 объявлений и 40 000 поисковых сессий за 90 дней: 6 регионов × 5 категорий, seed 42. Ответ — латентная продажа — записан в _truth/ground_truth.json и не участвует в анализе: AST-тест test_no_truth_leak.py статически запрещает модулям анализа импортировать или открывать этот файл.
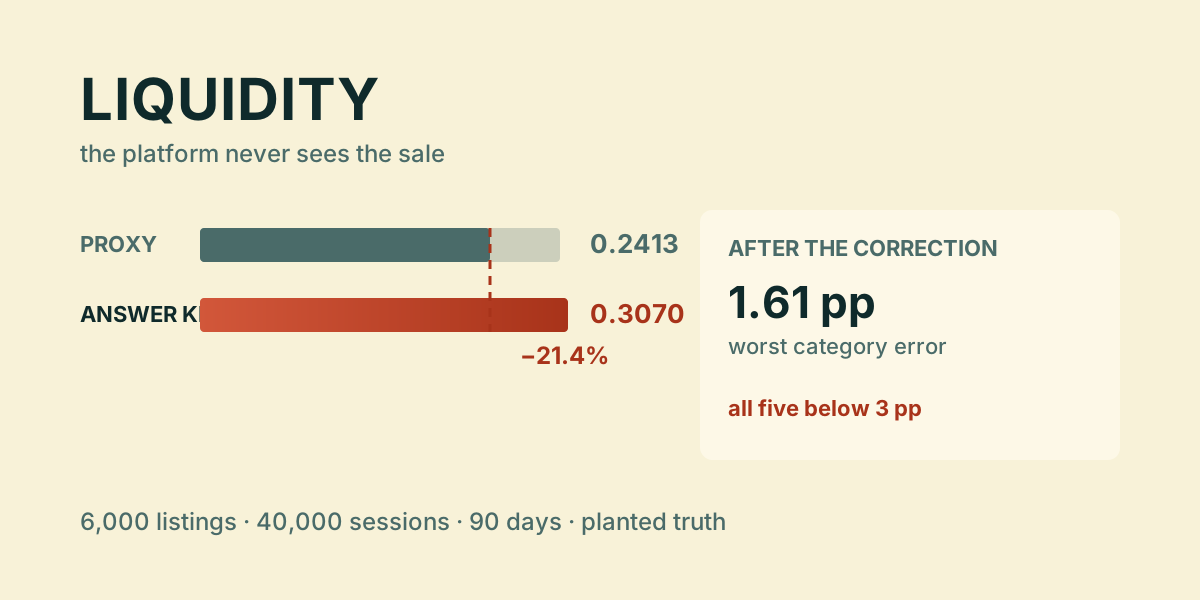
Прокси и истина. Сравнил removal_reason == "sold" с латентной истиной на когорте из 1 956 объявлений, опубликованных в первые 30 дней. Прокси даёт 0,2413 против 0,3070 — ошибка −0,0657, относительная −21,4%.
Поправка. Разложил наблюдаемый отклик на две компоненты — проданное и непроданное — и оценил смесь EM по сигналам ответа и задержки. Поправка считается по категориям, а не одной константой: ошибка прокси различается между ними.
Проверка поправки. Оценил восстановление истины на отложенном сегменте с жёстким допуском 3 п.п. и прогнал тест чувствительности: если убрать сепаратор SOLD_REPLY_LAG_MAX = 4.5 или сдвинуть отсечку до 2 дней, восстановление обязано сломаться — иначе тест ничего не проверяет.
Платная видимость. Дал 10% объявлений случайный буст в пределах категории. Сравнил наивное «до/после» с контрастом против холдаута по контактам на сессию; отдельно посчитал гардрейлы — органические контакты и долю ответов.
Проверки. 61 тест: восстановление истины, чувствительность к сепаратору, обязательное падение наивной оценки, отсутствие утечки истины, идемпотентность генератора.
Результат
- Ошибка прокси: 0,2413 против 0,3070, −0,0657 (−21,4%) на когорте из 1 956 объявлений.
- После поправки: худшая категория ошибается на 1,61 п.п., все пять укладываются в допуск 3 п.п.
- Наивная видимость: 0,4702 → 1,0027 контакта на объявление, +113% — но это отбор, а не эффект.
- Причинный контраст: −0,0116 контакта на сессию (−2,47%), Welch p = 0,308, интервал (−0,0346; 0,0084) — ноль не исключён.
- Гардрейлы: органические контакты −10,9%, доля ответов 56,6% против 64,4% у неплатных.
- Отрицательный контроль: наивная оценка обязана «улучшиться» — тест падает, если этого не происходит.
Ограничения
Данные синтетические: это доказательство о механизме измерения, а не об Avito. Генератор задаёт мир, в котором смесь восстанавливается; поправка проверяет спецификацию, а не валидируется на независимом источнике.
Восстановление держится на сепараторе, который совпадает с генератором: без него худшая ошибка растёт до 12,1 п.п., при отсечке 2 дня — до 15,82 п.п.
Знак причинного эффекта подсказывает направление, но не стабилен: интервал широкий, потому что сессии считаются независимыми, хотя покупатели повторяются. Это записано как ограничение, а не спрятано в сноске.
Один seed, одно окно, нет валидации по отдельным объявлениям и нет проверки чувствительности к длине окна. Все десять ограничений перечислены в отчёте.
Документация
README.md— постановка, таблица прокси против истины и границы применимости.docs/preregistration.md— знаки смещения по категориям, зафиксированные до прогона.- Быстрый старт:
uv sync --all-groups→uv run python -m liquidity.generate→uv run pytest→uv run python -m liquidity.bias. uv run python -m liquidity.monetization— холдаут платной видимости и гардрейлы.