RAG Evaluation Harness — retrieval and generation metrics
▶ Схема потока данных — самодостаточный HTML, открывается в браузере — без установки и сборки
Ситуация
RAG-пайплайн легко показать на одном удачном вопросе и почти невозможно измерить: непонятно, где именно теряется качество — в поиске документов или в генерации ответа, — и воспроизводится ли результат вообще без внешних сервисов. Без офлайн-харнесса любое «стало лучше» остаётся впечатлением, а не числом.
Задача
От меня требовалось собрать RAG end-to-end и отдельно измерить каждый слой: метрики ретрива (recall@k, MRR, precision@k) на размеченном наборе вопросов и метрики генерации (faithfulness, answer correctness). Харнесс должен работать без API-ключей и оставаться тем же при подключении LLM.
Действия
Корпус — 12 коротких документов по аналитике (A/B-тесты, CUPED, uplift, retention, churn, RFM, воронка, LTV, атрибуция, когорты, DAU/MAU, оконные функции SQL), нарезанных на чанки и проиндексированных TF-IDF с 1–2-граммами.
- Retrieval — cosine top-k по TF-IDF-матрице; зависимостей минимум, полностью офлайн. Эмбеддинг-бэкенд можно подключить, не трогая код оценки.
- Generation — Claude, заземлённый на найденном контексте, если задан ключ; иначе детерминированный экстрактивный фолбэк возвращает самое релевантное предложение из top-документа. Оба пути возвращают одну и ту же запись
Generation, поэтому оценка воспроизводима офлайн. - Evaluation — 20 размеченных вопросов (
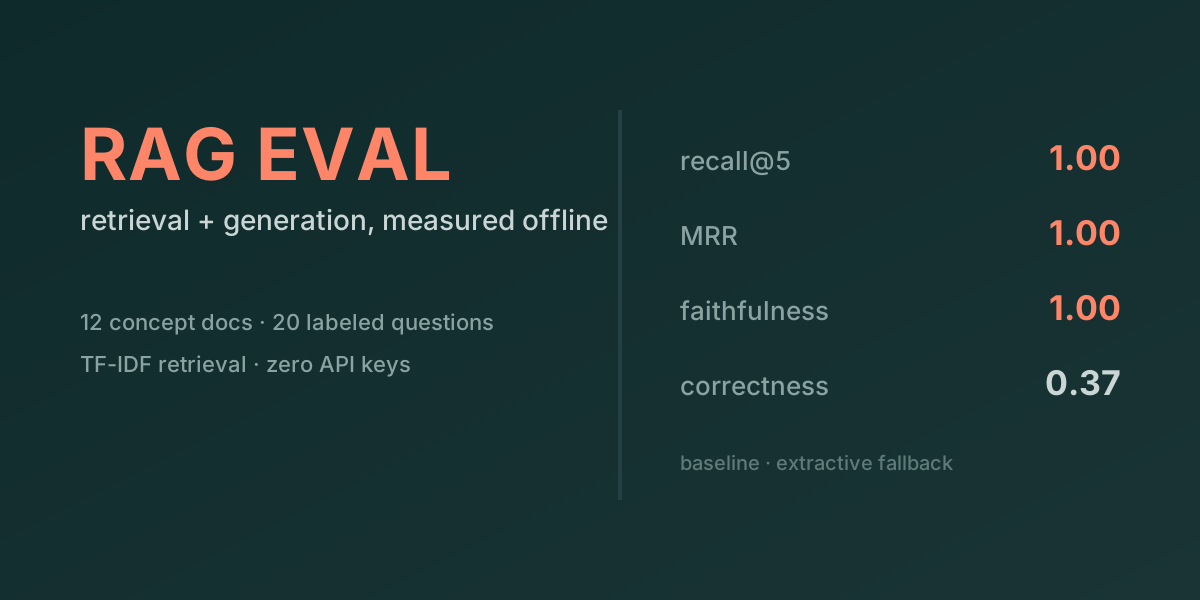
data/eval.jsonl) с gold doc id и эталонным ответом. Ретрив: recall@k, MRR, precision@k. Генерация: faithfulness (доля токенов ответа, заземлённых в контексте) и answer correctness (Jaccard-пересечение с эталоном).
| Метрика | Значение |
|---|---|
| recall@5 | 1.00 |
| MRR | 1.00 |
| precision@5 | 0.20 |
| faithfulness (инвариант, экстрактив) | 1.00 |
| correctness | 0.37 |
Запуск
uv run --with scikit-learn --with pandas --with numpy python run.py query "How is the CUPED theta coefficient computed?"
uv run --with scikit-learn --with pandas --with numpy python run.py eval
# с реальной LLM (нужен ANTHROPIC_API_KEY):
uv run --with scikit-learn --with pandas --with numpy --with anthropic python run.py eval --llm
uv run --with scikit-learn --with pandas --with numpy --with pytest pytest -q
Разбор по вопросам: reports/retrieval_per_question.csv, reports/generation_per_question.csv.
Результат
Ретрив на этом корпусе идеален: recall@5 и MRR = 1.00, gold-документ стоит на ранге 1 для всех 20 вопросов — TF-IDF хватает при таком масштабе и хорошем разделении тем. Офлайн-экстрактивный базлайн заземлён по построению — faithfulness ≡1.00, потому что ответ берётся из контекста, — и набирает 0.37 correctness по пересечению токенов.
Главная ценность — не числа сами по себе, а то, что харнесс разводит слои. С --llm и ключом качество генерации растёт, а метрики ретрива не меняются, поэтому видно, какой именно слой улучшать. Это тот же принцип, что и в A/B: сначала измерь, потом меняй.
Ограничения
Faithfulness здесь — прокси заземлённости (токены ответа в контексте), а не проверка истинности: ответ может опираться на найденный контекст и всё равно быть неверным. Correctness по Jaccard чувствителен к формулировке — низкий балл не всегда ошибка. Корпус мал (12 документов, 20 вопросов), поэтому recall@5 = 1.00 — свойство этого набора, а не обещание на реальных данных; при росте корпуса метрику нужно пересчитать.