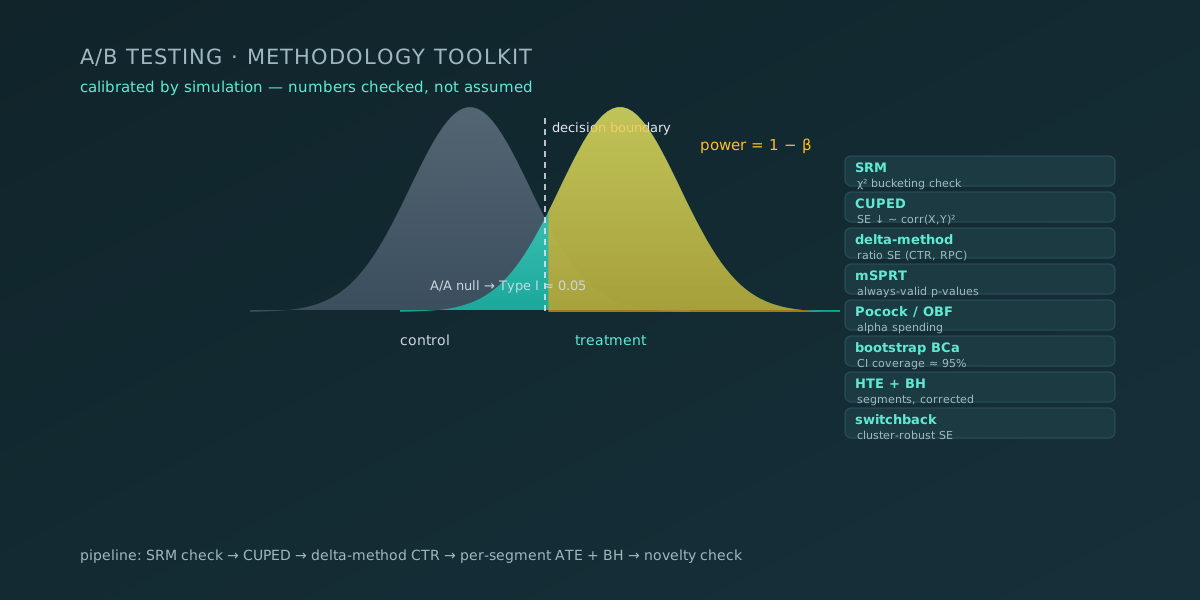
A/B Testing Methodology Toolkit
Ситуация
Метод A/B-теста хорош ровно настолько, насколько хороши его ошибка первого рода под нулевой гипотезой и мощность под реальным эффектом.
На практике эти обещания редко проверяют:
- наивный peeking,
- неправильный SE для ratio-метрик
- и множественное тестирование молча ломают решения.
Тулкит реализует 15 методов из первичной литературы и калибрует каждый симуляцией — вместо веры в асимптотику.
Задача
От меня требовалось сделать свойства методов проверяемыми: чтобы заявление о контроле ошибки подкреплялось прогоном, а не ссылкой на литературу.
Действия
Модули
| Модуль | Метод | Что показывает демо |
|---|---|---|
srm_test.py |
Sample Ratio Mismatch (χ²) | ловит бакинг-баги до любых downstream-тестов |
sample_size.py |
Fixed-horizon sizing | n/arm для пропорций и средних |
delta_method_ratio.py |
Ratio-метрики (CTR, RPC) | корректный SE для ΣY/ΣX; наивный per-unit t-test смещён |
cuped.py |
Variance reduction | дисперсия ↓ на ρ², SE — примерно в ρ раз, за счёт pre-period |
group_sequential.py |
Alpha-spending границы | Pocock/OBF держат Type I, пока наивный peeking его раздувает |
msprt_always_valid.py |
Always-valid p-values | mSPRT позволяет смотреть и останавливаться когда угодно |
sequential_ratio.py |
Sequential ratio-метрики | delta-method + mSPRT для CTR под мониторингом |
sequential_ab_testing.py |
Sequential rule Эвана Миллера | воспроизводит таблицу размеров, валидирует Type I/power, экономию выборки |
bayesian_ab_test.py |
Analytic Bayesian A/B | Beta-Binomial / Normal-Normal, P(B>A), expected loss, ROPE |
bootstrap_ci.py |
Bootstrap CI | percentile и BCa для скошенных метрик |
heterogeneous_treatment_effects.py |
HTE по сегментам | interaction-модель ловит Simpson-подобное зануление |
multiple_comparisons.py |
Множественное тестирование | Bonferroni (FWER) vs Benjamini-Hochberg (FDR) |
novelty_primacy.py |
Time-varying effects | treat×day interaction ловит novelty decay / primacy growth |
switchback.py |
Cluster & switchback | cluster-robust SE; carryover bias |
test_simulator.py |
Generic calibration | любой DGP + тест → эмпирические Type I и power |
Сквозной пайплайн
scripts/run_full_pipeline.py связывает модули в один реалистичный сценарий на синтетических данных: SRM check → CUPED → delta-method CTR test → per-segment ATE с BH-коррекцией → novelty check → markdown-отчёт в outputs/report.md.
Запуск
uv sync --all-groups
uv run pytest                 # calibration test suite
uv run python scripts/run_full_pipeline.py   # end-to-end demo → outputs/report.md
Результат
Тестовый набор перепрогоняет каждую калибровку с ассертами:
- Type I error ≈ α (± tolerance) для каждого метода под его нулевой гипотезой;
- покрытие CI ≈ 95% для bootstrap;
- наивный peeking раздувает Type I, always-valid / alpha-spending контролируют его;
- наивный per-unit SE для ratio-метрик неточен, delta-method точен;
- корректность на known-answer фикстурах (SRM splits, сегментные uplift-ы).
Ограничения
Числа получены на симуляциях с заданным DGP, а не на прод-трафике: калибровка подтверждает корректность реализации, но не гарантирует, что реальные данные удовлетворяют её допущениям.
Это набор инструментов, а не замена продуманному дизайну эксперимента.