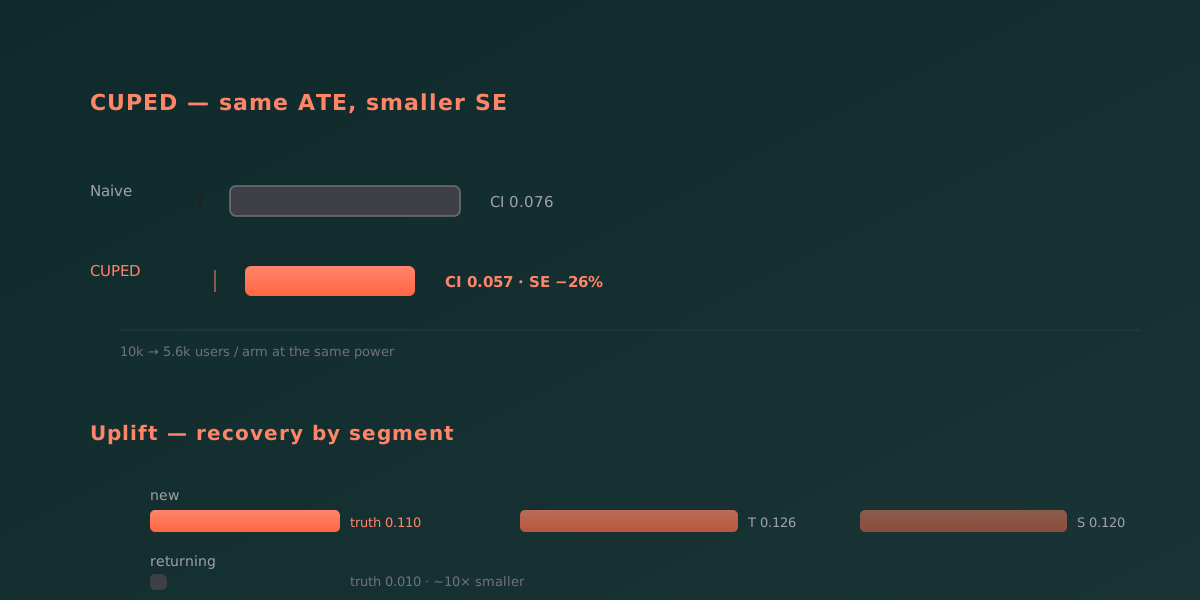
Causal / Uplift — CUPED and Individual Treatment Effects
▶ Схема потока данных — самодостаточный HTML, открывается в браузере — без установки и сборки
Ситуация
Обычный двухвыборочный t-тест отвечает только на вопрос «работает ли эффект в среднем» и не использует пред-период. Из-за этого эксперименты просят больше трафика, чем нужно, а retention-акции уходят всем, хотя реагирует лишь часть аудитории.
Проект закрывает оба пробела: CUPED снижает дисперсию по ковариате из пред-периода, uplift-моделирование оценивает индивидуальный эффект (ITE). Оба метода работают на синтетическом рандомизированном эксперименте с известным гетерогенным эффектом, поэтому оценки можно сверить с ground truth.
Задача
От меня требовалось реализовать оба метода и доказать, что они не смещают оценку на данных, где правильный ответ известен заранее.
Действия
Данные синтетические и детерминированные (seed = 42), 20 000 пользователей в рандомизированном эксперименте:
segment—new(30%) /returning(70%) → гетерогенный эффект воздействия;x_pre— ковариата пред-периода, коррелированная с исходом (ρ ≈ 0.67);treatment— 50/50, независим от всего (чистая рандомизация);tau_true— истинный индивидуальный эффект (только для оценки);y_cont— непрерывный исход;y_bin— бинарная конверсия.
CUPED — та же оценка ATE, меньше дисперсия:
| Метод | ATE | SE | 95% CI |
|---|---|---|---|
| Naive | 0.270 | 0.019 | [0.232, 0.308] |
| CUPED | 0.276 | 0.014 | [0.247, 0.304] |
Uplift — индивидуальный эффект, T- и S-learner:
| Модель | AUUC | QINI | uplift@20% | corr(τ) |
|---|---|---|---|---|
| T-learner | 0.0043 | 0.0014 | 0.072 | 0.50 |
| S-learner | 0.0057 | 0.0029 | 0.041 | 0.66 |
| Random | 0.0037 | 0.0008 | 0.022 | −0.007 |
Запуск
uv run --with pandas --with numpy python data/generate_data.py
uv run --with pandas --with numpy --with scikit-learn --with lightgbm --with matplotlib python run.py
uv run --with pandas --with numpy --with scikit-learn --with lightgbm --with matplotlib --with pytest pytest -q
Результаты: reports/metrics.json + reports/uplift.png (QINI-кривые + сегментный uplift против ground truth).
Результат
CUPED даёт мощность бесплатно: новый дизайн эксперимента не нужен, нужен лишь лучший оценщик на уже собранных данных — при условии, что есть ковариата из пред-периода. Точечная оценка не меняется (0.270 → 0.276, в пределах шума), стандартная ошибка сжимается на ~26%, CI сужается в 1.35× — эксперимент, которому нужно было 10k пользователей на руку, обходится ~5.5k.
Uplift отвечает на другой вопрос, чем A/B-тест: не «работает ли воздействие в среднем», а «на ком оно работает». На n = 6000 метрики кривых шум-доминированы: T-learner стоит на 0.81σ от нулевого эталона (AUUC +0.00293 ± 0.00164), S-learner — на 1.72σ, и даже оракул, ранжирующий по известному истинному τ, — только на 2.25σ; случайный скорер стоит на 0.46σ — там, где и должен независимый базлайн, так что оракул остаётся потолком. Ясны не AUUC и QINI, а восстановление сегментов и corr(τ) = 0.50–0.66 против −0.01 у случайности. Модели восстановили форму эффекта: новые пользователи реагируют в 6.3–6.8 раза сильнее возвращающихся (эталонный разрыв — 8.4 раза) — тот самый сигнал, по которому действовала бы скидочная кампания.
- Правило запуска (pre-registered): порог окупаемости 0.05 — кампания отправляется только на сегмент
new, наreturningне запускается.
| Сегмент | Truth (binary uplift) | T-learner | S-learner |
|---|---|---|---|
| new | 0.110 | 0.126 | 0.120 |
| returning | 0.013 | 0.018 | 0.019 |
Ограничения
Латентная ground-truth τ равна 0.60 (new) / 0.08 (returning), но конверсионный uplift ~0.11 / 0.01: сигмоида при высокой базовой конверсии (~71%) дампит большие латентные эффекты. Сравнивать предсказанный бинарный uplift с латентной τ было бы несовпадением шкал, поэтому приведена ранговая корреляция (без масштаба) и по-сегментное эмпирическое восстановление.
На реальных данных ITE не наблюдается никогда — синтетика с известным гетерогенным эффектом здесь единственная причина, по которой восстановление вообще можно проверить; это фундаментальное ограничение causal inference, а не недостаток метода.