CRM Experiment Lab — сегментная рандомизация, GCG и нетто-эффект
Ситуация
CRM-команда переносит привычки продуктового A/B-теста в рассылки и ломается уже на рандомизации. Пользователя бакетируют в тот момент, когда он «появился» в день запуска, а не когда собран сегмент кампании. В контрольную группу попадает лишь часть опоздавших, доли плеч расходятся, и SRM-проверка срабатывает на чистом назначении.
Дальше начинаются те же грабли на других слоях: глобальная контрольная группа обновляется полным перемешиванием и роняет базу сравнения, эффект кампании считается без цены отписок, а окно экспозиции выдают за бесплатное снижение дисперсии.
Лаборатория собирает все эти слои в одном синтетическом эксперименте с известным ответом, чтобы каждый шаг можно было проверить и сломать наглядно.
Задача
Мне нужно было собрать площадку, на которой этапы CRM-эксперимента проверяются на данных с заранее известным ответом, и показать, где перенос продуктовой логики даёт ложный результат, а не просто «другую цифру».
Действия
Симулятор и замороженная модель данных
Один прогон — 20 000 пользователей, 28 дней, 12 кампаний, seed 42. Пять таблиц (users, campaigns, assignments, exposures, outcomes) зафиксированы контрактом до реализации: модули не могут тихо разойтись в схеме.
assignmentsхранитgroup ∈ {test, control, gcg}иstage ∈ {segment, exposure}— этап рандомизации виден в данных;campaignsнесётtrue_lift_ppиtrue_unsub_pp, то есть истинный эффект каждой кампании;outcomesдаёт покупки, сумму покупки, отписку и сессии на пользователя-день.
Рандомизация: сегмент против показа
Сравниваются два способа бакетирования при одном и том же назначении. Сегментный держит фиксированную долю и проходит SRM; бакетирование по первому показу отбрасывает опоздавших из контроля и раздувает долю теста.
| Этап | Доля теста | SRM p-value |
|---|---|---|
| сегмент (корректно) | 0.4958 | 0.266 |
| первый показ (продуктовый) | 0.5629 | 0 |
Глобальная контрольная группа
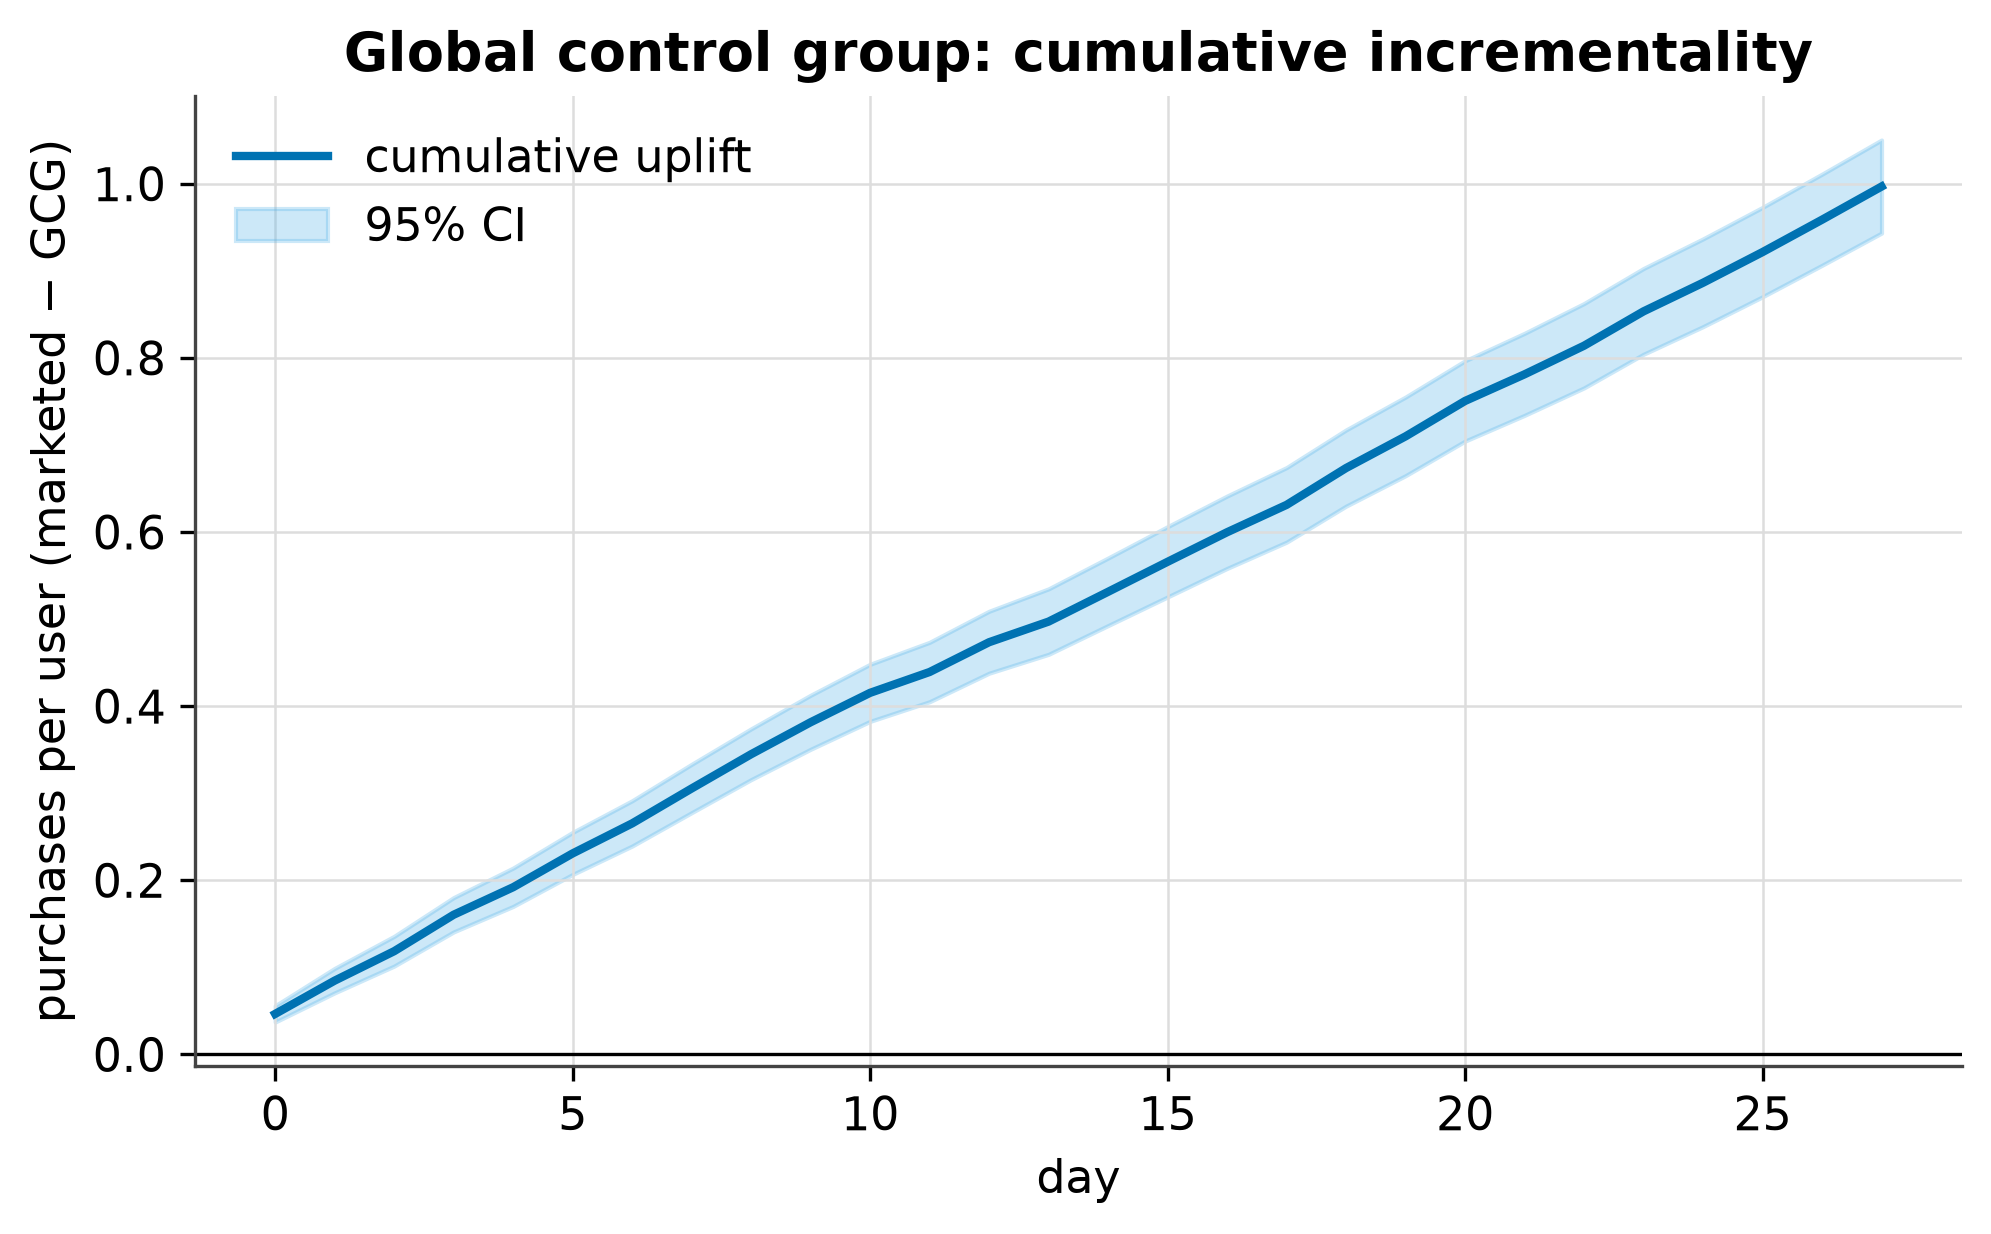
Аплифт считается как «маркетинг минус глобальный контроль», поэтому стабильность контроля — часть оценки. Полное перемешивание поднимает коэффициент вариации тренда до 0.3280, частичная ротация по конфигу — до 0.0090.
Балансировщик отправок
Дневной кап — три отправки на пользователя. Балансировщик распределяет 12 кампаний по пользователю и дню; превышений капа — ноль user-days. Без него частота отправок растёт вместе с числом кампаний, и отписки перестают быть управляемой ценой.
Нетто-эффект с ценой отписок
Кампания окупается, только если инкрементальные покупки перекрывают инкрементальные отписки. Обе стороны нормируются на 1 000 обработанных: +212.8 покупок против −162.3 отписок, нетто +50.5 при отношении 1.311.
Окно экспозиции и guardrails
Метрика Is Exposed = True привязывает оба плеча к первому дню показа. На постоянном эффекте это якорь горизонта, а не снижение ошибки; на транзиентном — отношение эффекта к SE растёт с 7.55 до 12.28. Иерархия метрик — OEC (revenue), драйверы, прокси, отладочные и guardrails — задана явно, чтобы одна метрика не оптимизировалась в одиночку.
A/B-ридаут
Отдельный отчёт фиксирует гипотезу, дизайн и решение до запуска: MDE 0.06765 абсолютных (10% относительных), 751 пользователь на плечо, alpha 0.05, power 80%. SRM на запланированной доле: chi2=1.2395, p=0.2656. Кластер-робастная ошибка по пользователю совпадает с построчной (1.00x), потому что генератор не даёт внутрипользовательской корреляции.
Проверки
Набор pytest из девяти модулей калибрует статистику, балансировщик, GCG, окно экспозиции и позитивность; ruff держит стиль. Пайплайн запускается одной командой и переписывает отчёт и три фигуры.
uv sync --all-groups
uv run pytest
uv run python scripts/run_full_pipeline.py
Результат
| Анализ | Результат | Чтение |
|---|---|---|
| Рандомизация (SRM) | сегмент p=0.266, показ p=0 | фиксированная доля сбалансирована, бакетирование по активности — нет |
| GCG-аплифт к дню 27 | +0.9968 [0.9433, 1.0502] | 95% интервал не содержит нуля |
| Стабильность GCG | CV полная 0.3280 против частичной 0.0090 | частичная ротация держит базу |
| Нетто на 1 000 обработанных | +50.5 (212.8 − 162.3) | положительно, отношение 1.311 |
| Окно экспозиции | SE 0.00066 против 0.00124 | окно якорит горизонт, а не режет SE |
| Guardrails | нарушен 1 из 2 | отписки пробиты, дневной кап держится |
Практический вывод — не «кампания работает», а «работает при явном churn-бюджете». Строгий guardrail «отписки не выросли» недостижим ни при каком объёме отправок: тест получает сообщения, контроль — нет. С бюджетом 12% отправка проходит при капе 2, а максимум нетто приходится на кап 2 (+56.8 на 1 000): меньше отправок — меньше отписок, и потеря аплифта меньше выигрыша по churn. Вердикт ридаута — Investigate, а не Ship: основная метрика выигрывает, guardrail падает.
Ограничения
Главная честная оговорка: data/experiment_sample.csv — пример схемы исходов на 300 строк без колонки group, поэтому заголовочные числа из него не воспроизводятся. Все цифры выше получены симулятором (scripts/run_full_pipeline.py), а не этим CSV.
Данные синтетические и из известного генератора: нет интерференции между пользователями, ботов, отложенных конверсий и потерь логов, а внедрённый аплифт постоянен во времени. Сравнения GCG и окна экспозиции — оценки, прогнанные на одном seed, а не исследование мощности. Настоящего сервиса назначения, хранилища метрик и мониторинга здесь нет: это площадка для одного эксперимента, а не платформа экспериментирования.