Churn Prediction — Leakage-Free Retention Model
▶ Схема потока данных — самодостаточный HTML, открывается в браузере — без установки и сборки
Ситуация
Трудность модели оттока для подписочного продукта — не в алгоритме, а в дисциплине оценки: признаки должны считаться as-of на дату снимка, метка — быть будущим окном неактивности, а разбиение — хронологическим.
Случайный train/test-сплит подкладывает будущую активность пользователя в обучение и его прошлое в тест: модель показывает красивое число, которого в проде не будет. Проект существует ради устранения этой утечки — тот же принцип, что и в A/B-анализе: «никакого будущего в моделируемом моменте».
Задача
От меня требовалось получить число, которому можно верить в проде: оценить модель так, чтобы качество на тесте не было следствием утечки.
Действия
Данные синтетические и детерминированные (seed = 42): 12 000 пользователей регистрируются с июня 2023 по январь 2024, канал задаёт tenure (экспоненциальное время жизни), тариф — вероятность дневной активности; активность слегка затухает к оттоку; базовый уровень base_rate = 0,174 на снимок — артефакт смеси, а не доля оттока.
Признаки и метка
- Признаки as-of — recency, активность за 7/14/30 дней, tenure, недавний тренд, средние сессии + категориальные
channel / device / country / plan.
- Метка без утечки — отток = нет активности в
[snapshot, snapshot+30d] у пользователя, активного предыдущие 30 дней. Давно «мёртвые» пользователи исключены, а не помечены: предсказывать на призраках — не задача.
Сплит и метрика
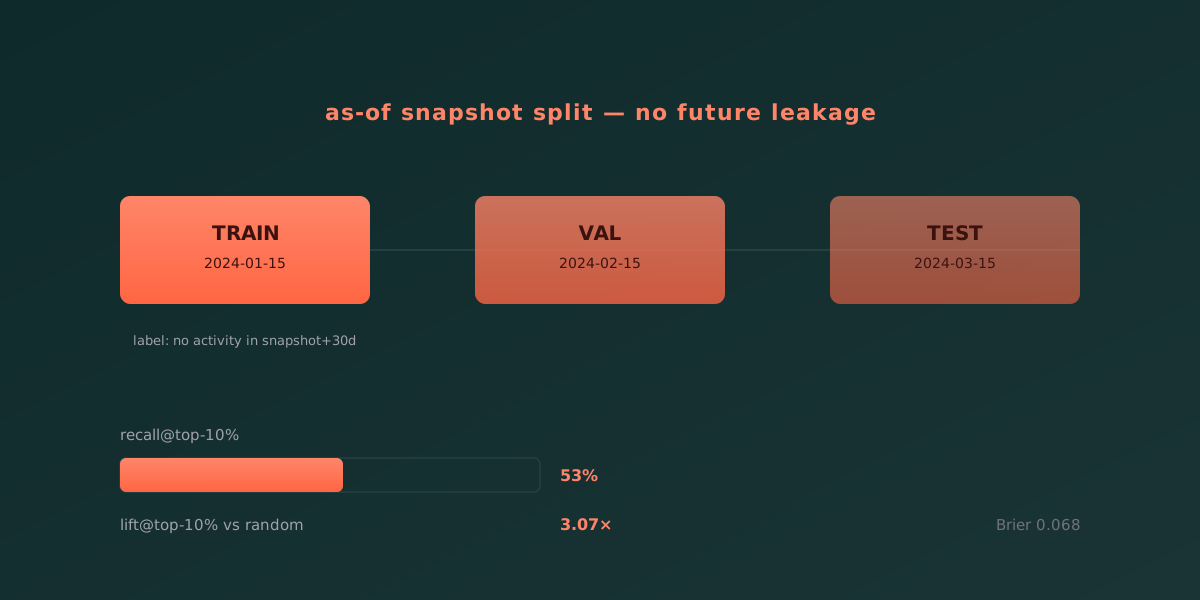
- Хронологический сплит — train (2024-01-15) → val (14.02.2024) → test (2024-03-15). Случайный сплит подложил бы будущую активность пользователя в обучение и его прошлое в тест — это скрытая утечка, и ради её устранения проект и существует.
- Метрика бизнеса вперёд — ROC-AUC и PR-AUC считаются, но решение принимают по recall@top-decile и lift@top-decile: если retention работает с топ-10% самых рискующих, сколько реальных отточников мы ловим.
Модель и тесты
- SHAP — нативный
predict_proba(pred_contrib=True) LightGBM (TreeSHAP без зависимости от пакета shap). Доминирует recency_days.
- Бейзлайн — логистическая регрессия, обученная честно (без
class_weight="balanced", который искажал вероятности).
- Тесты — 39 pytest: свойства без утечек (удаление будущей активности не меняет признаки), целостность конфига, метрики и графики.
| Метрика (test snapshot) |
LightGBM |
LogReg |
| ROC-AUC |
0.916 |
0.917 |
| PR-AUC |
0.824 |
0.828 |
| Recall@top-10% |
0.544 |
0.537 |
| Lift@top-10% |
5.44× |
5.37× |
| Brier (калибровка) |
0.063 |
0.062 |
Запуск
# Python >=3.10. Deps: pandas, numpy, scikit-learn, lightgbm, matplotlib.
uv run --with pandas --with numpy python data/generate_data.py
uv run --with pandas --with numpy --with scikit-learn --with lightgbm --with matplotlib python run.py
uv run --with pandas --with numpy --with scikit-learn --with lightgbm --with matplotlib --with pytest pytest -q
Результаты складываются в reports/: metrics.json + evaluation.png (ROC, PR, SHAP bar).
Результат
LightGBM и логистика идут вровень: синтетические признаки почти линейны, и линейная модель их не хуже — LogReg даже чуть впереди по AUC, PR-AUC и Brier (0.062 против 0.063). Честный вывод: бустинг здесь трофея не берёт. Проект доказывает схему оценки без утечек, а не превосходство GBM. Признак recency_days настолько силён, что потолок lift низкий у любой модели: в топ-10% самых рискующих модель ловит 54,4% реальных отточников при lift 5,44×.
- Денежный порог: скор превращается в решение о деньгах — стоимость оффера и ценность удержанного клиента задают минимальную вероятность, ниже которой контакт не окупается.
- Честный масштаб: на at-risk подгруппе (n = 1 692 из 5 581) lift падает до 1,75×, а Brier растёт до 0.163 / 0.157 — заголовочные метрики набраны в основном на тех, кто и не мог отвалиться внутри окна метки.
Ограничения
Признаки синтетические и почти линейны — выигрыш бустинга в ранжировании на них не показателен. Проект доказывает схему оценки без утечек и калибровку скора, а не превосходство GBM над логистикой. Потолок lift задаёт сила recency_days, а не качество модели, — на других данных разрыв может быть выше.
Частые вопросы
Почему сплит хронологический, а не случайный?
Случайный сплит подкладывает будущую активность в обучение: качество на тесте становится следствием утечки, а не сигнала.
Как определяется метка оттока?
Это окно неактивности 30 дней вперёд, и только для недавно активных пользователей.
Какое качество у модели?
ROC-AUC 0.916: в топ-10% самых рискующих модель ловит 54,4% реальных отточников при lift 5,44×.
Почему метрика решения — recall, а не только AUC?
Кампания удержания бьёт по верхушке списка риска, поэтому решение принимается по recall@top-10% и lift.
Зачем смотреть Brier?
Brier чувствителен к калибровке вероятностей: 0.063 у LightGBM против 0.062 у честно обученной логистики — это ничья. Прежний Brier 0.099 был артефактом unbalanced-бейзлайна.