Режим просмотра: Менеджер Переключить: HR Коллега

Продуктовый аналитик

Решения по данным с измеримым эффектом

Считаю не отчёты, а решения: какой фикс включать, кого вернуть, где гипотеза не подтвердилась.

5 лет в данных
17 проектов в портфолио
+5.72 п.п. KYC-конверсия
€656K/год годовой эффект фикса

Бизнес-цифры — кейс портфолио Volta (синтетические данные), не результаты найма.

Стек

Анализ SQL Python DuckDB
Эксперименты A/B Causal Inference
Инфра GitHub Actions Supabase PostHog
Все проекты →

Все проекты

— перемещение стрелками ↑/↓ Volta Neobank — Product Analytics

Эксперименты

Volta Neobank — Product Analytics

Ситуация
«Volta» — вымышленный необанк, терявший пользователей на онбординге: у каждого отдела своя цифра, и ни одна не объясняла, где утекают деньги
Задача
Найти критический шаг онбординга и доказать вывод так, чтобы его нельзя было списать на удобную выборку
Действия
Одна петля discover → validate → measure → optimize: воронка, A/B прогресс-бара KYC, когорты, KMeans-сегментация, DiD-проверка причинности
Результат
KYC-фикс: +5,72pp конверсии (p<0,0001) → €656K/год при 44× ROI; M3-удержание +9,2pp
Pythonpandas / NumPy +4
— перемещение стрелками ↑/↓ Causal / Uplift — CUPED and Individual Treatment Effects

Эксперименты

Causal / Uplift — CUPED and Individual Treatment Effects

Ситуация
Двухвыборочный t-тест не использует пред-период: эксперименты просят лишний трафик, а retention-акции уходят всем
Задача
Реализовать CUPED и uplift-моделирование и доказать отсутствие смещения там, где верный ответ известен заранее
Действия
CUPED на ковариате пред-периода и T-/S-лернеры на LightGBM; сверка с ground truth по AUUC и QINI
Результат
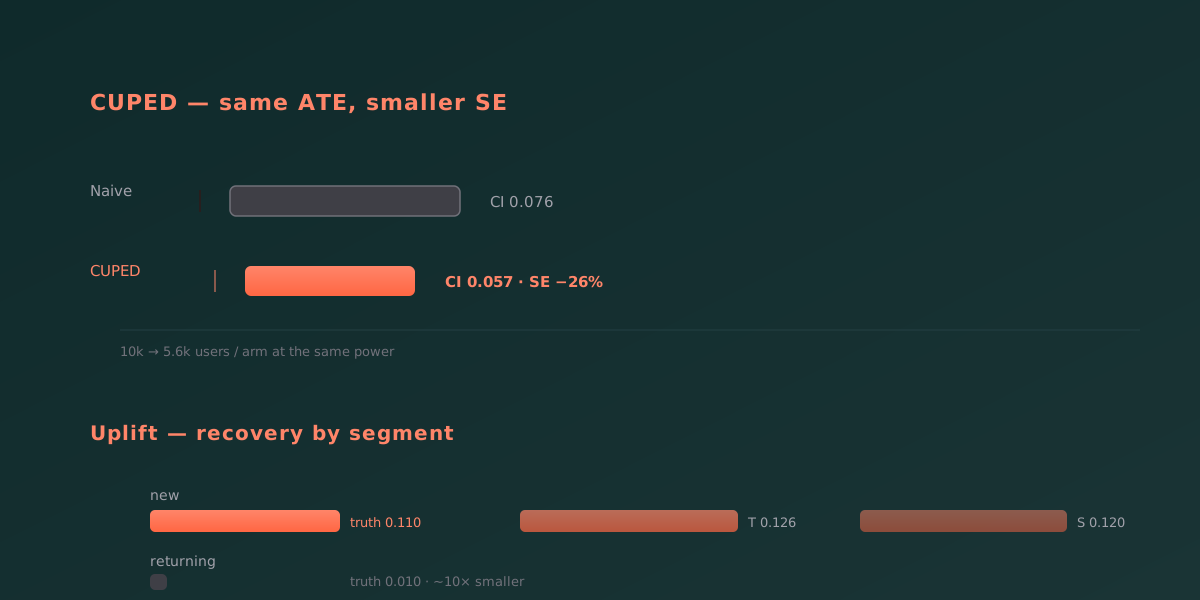
Стандартная ошибка меньше на ~26%; 5,6k пользователей на руку вместо 10k; новые реагируют ~10× сильнее возвращающихся
PythonLightGBM +5
— перемещение стрелками ↑/↓ Cohort Analysis Dashboard

Аналитика

Cohort Analysis Dashboard

Ситуация
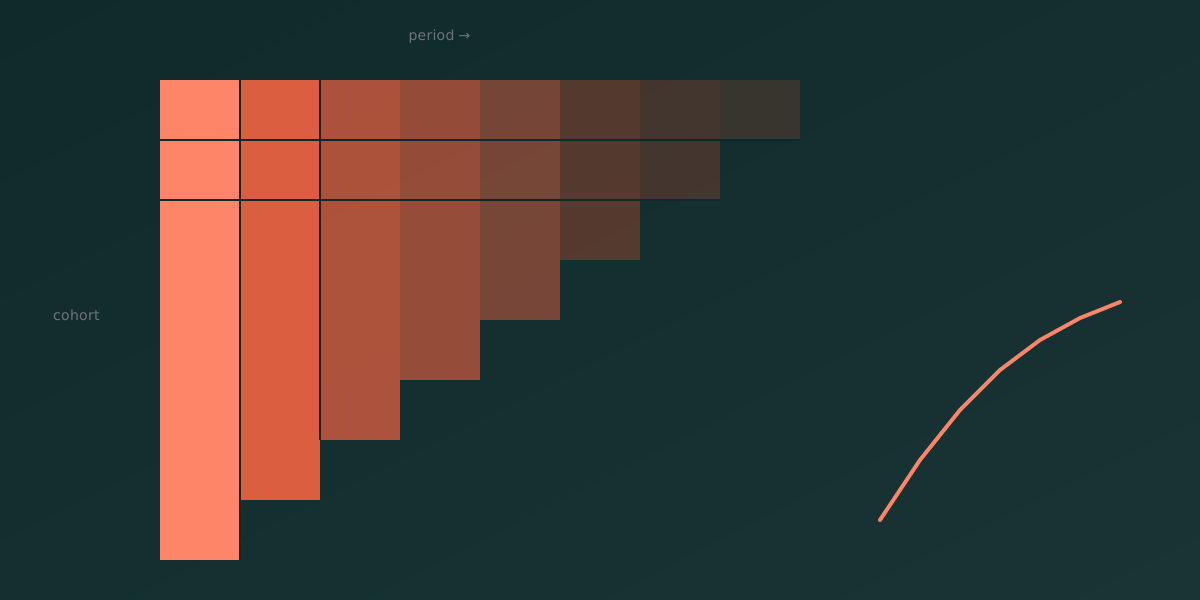
Когортный анализ удержания и LTV на синтетических данных: средний retention прячет динамику
Задача
Показать поведение каждой когорты отдельно, а не сглаженную среднюю по всей базе
Действия
Матрица удержания, ARPU и LTV по когортам, поправка на возраст наблюдения, выгрузка в Tableau (CSV + Hyper)
Результат
Когортная матрица вместо среднего retention: видно скорость оттока и расхождение монетизации с удержанием
Pythonpandas +3
— перемещение стрелками ↑/↓ SQL Analytics Case Study

Аналитика

SQL Analytics Case Study

Ситуация
Нет продакшен-данных, а учебные задачи не показывают системное мышление: 25 кейсов на синтетическом датасете
Задача
Собрать кейсы, где каждый запрос отвечает на продуктовый вопрос и воспроизводится одной командой
Действия
Самодостаточный .sql на кейс, генератор данных на DuckDB, dbt-слой staging → marts, regression-тесты, живой отчёт на Pages
Результат
Воронка теряет 54% на add-to-cart → checkout; retention с ~21% (D1) до ~5% (D30); повторных покупок 3.5%; на real data возвращаются 72.4%
SQLdbt +4
— перемещение стрелками ↑/↓ Churn Prediction — Leakage-Free Retention Model

Аналитика

Churn Prediction — Leakage-Free Retention Model

Ситуация
Модель оттока для подписочного продукта: случайный сплит подкладывает будущую активность в обучение
Задача
Оценить модель так, чтобы качество на тесте не было следствием утечки будущего
Действия
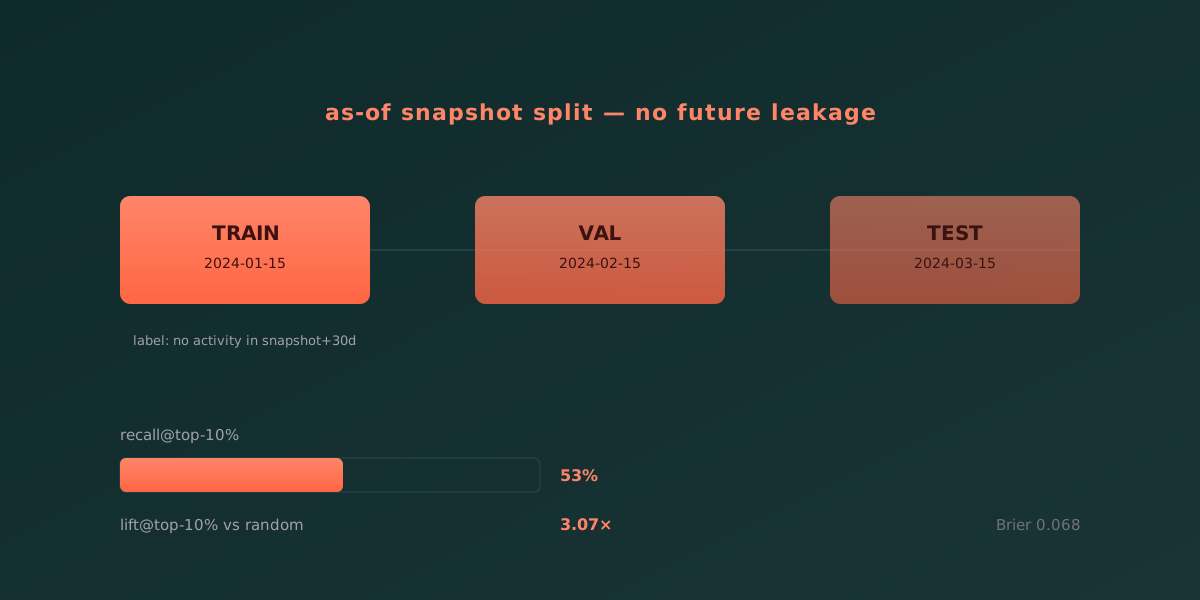
Признаки as-of, метка — будущее окно неактивности, хронологический сплит, решение по recall@top-decile и lift
Результат
В топ-10% самых рискующих модель ловит 53% реальных отточников при lift 3,07×
PythonLightGBM +5
— перемещение стрелками ↑/↓ RFM Analysis of Bank Clients

Аналитика

RFM Analysis of Bank Clients

Ситуация
Банк накапливает транзакции клиентов, а маркетинг шлёт всем одинаковые предложения
Задача
Заменить единое предложение адресным: для каждого сегмента — своя стратегия удержания
Действия
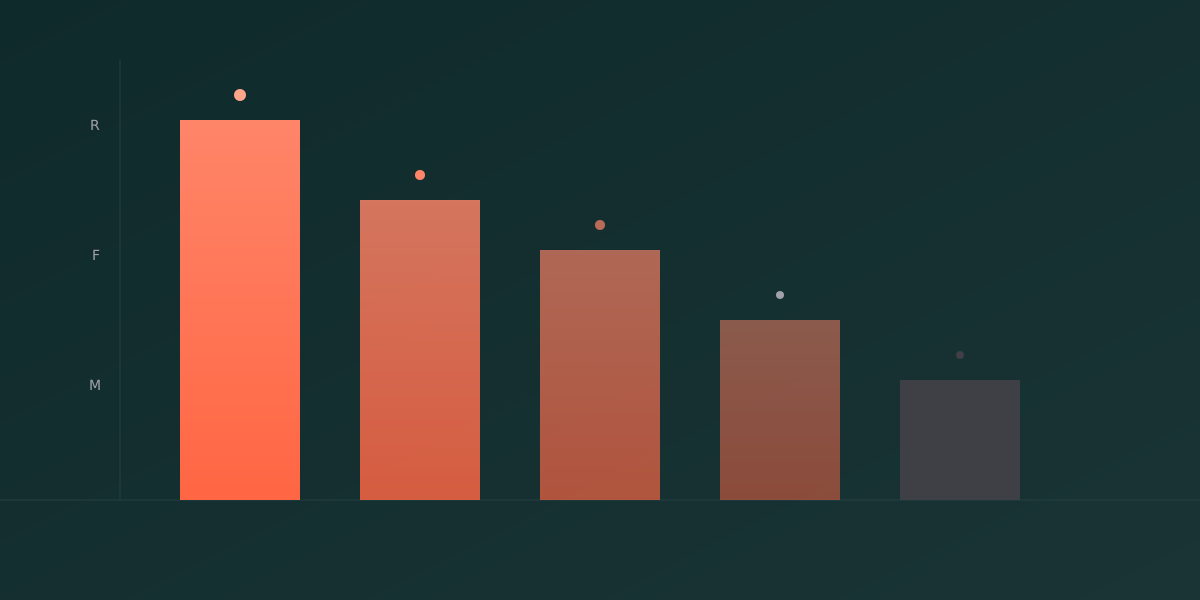
Очистка транзакций, расчёт Recency, Frequency и Monetary, RFM-скоринг, сегментация и визуализация в Tableau
Результат
Четыре RFM-группы: малая доля high-value даёт непропорционально большую часть дохода; маркетинг перешёл к сегментированным сценариям
PythonSQL +1
— перемещение стрелками ↑/↓ Product Analytics + A/B on Supabase

Продукт

Product Analytics + A/B on Supabase

Ситуация
Аналитическое портфолио показывает метрики на чистом CSV, а невидимой остаётся аналитика внутри multi-tenant продукта
Задача
Собрать слой целиком: авторизация, изоляция по организациям, приём событий и результат эксперимента, считаемый в базе
Действия
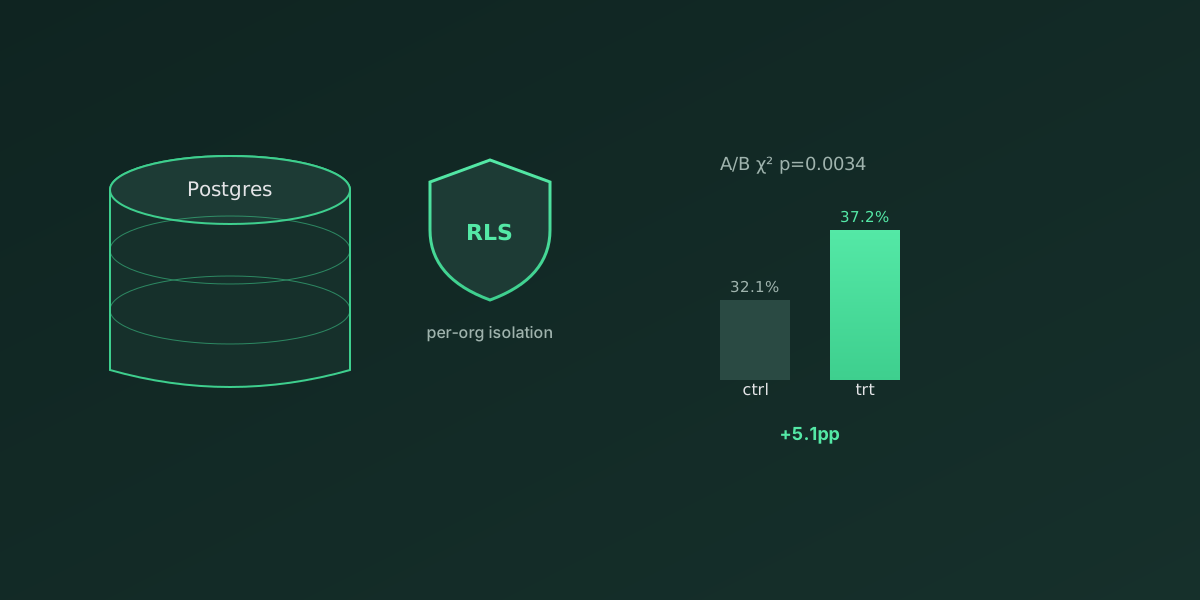
SQL-вьюхи считают funnel, cohort, MRR и DAU; v_results считает A/B в базе; RLS изолирует строки по организациям
Результат
Итог A/B: control 32.1% против treatment 37.2%, +5,1 пп при p = 0.0034 (χ²); метрики считаются в базе для любого клиента
PythonStreamlit +3
Открыть проект

Репозиторий приватный — доступ по запросу

— перемещение стрелками ↑/↓ TaskFlow — PostHog Product Analytics Pipeline

Продукт

TaskFlow — PostHog Product Analytics Pipeline

Ситуация
Аналитическое портфолио обычно начинается с готового CSV; здесь работа стартует раньше — с инструментирования приложения
Задача
Определить события без утечек PII, довести их до аналитического инструмента и превратить в решения
Действия
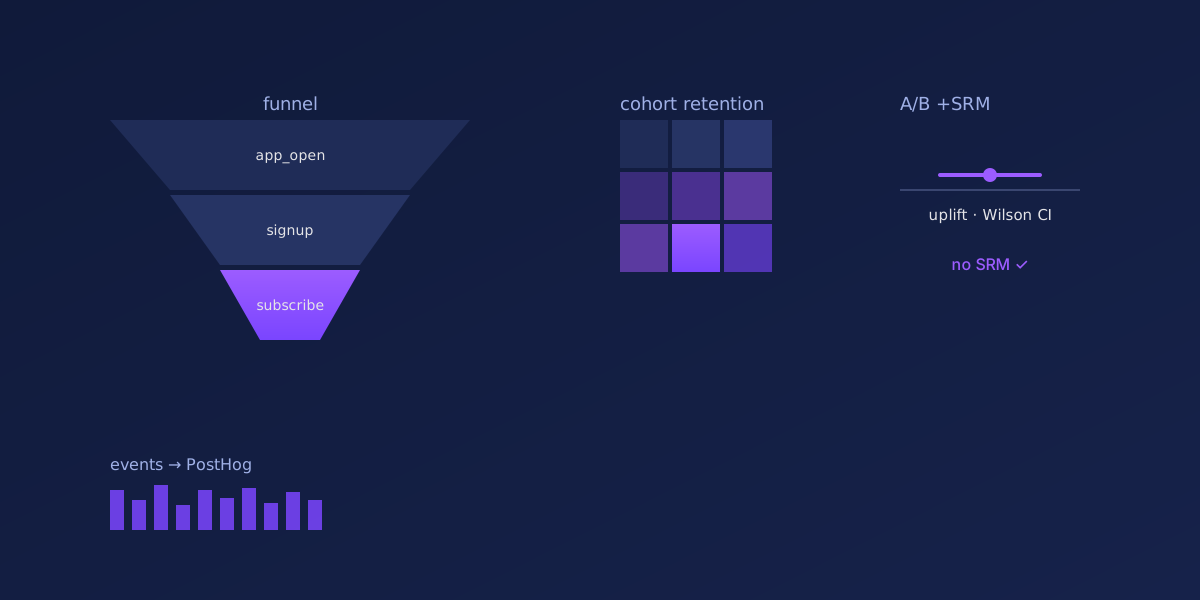
Каталог событий и скрабинг PII; A/B с chi-square, uplift, Wilson CI и SRM; SQL-зеркало метрик, Streamlit-дашборд, CI и Docker
Результат
Полный цикл аналитики: 7 анализов, типизированный каталог событий без утечек PII, метрики воспроизводимы и в Python, и в SQL
PythonPostHog +5
Открыть проект

Репозиторий приватный — доступ по запросу

— перемещение стрелками ↑/↓ This Portfolio Site

Инженерия

This Portfolio Site

Ситуация
Статическое портфолио на GitHub Pages: контент — проекты и посты — редактируется в Markdown, а не в разметке компонентов
Задача
Свести публикацию проекта к добавлению файла, без правки компонентов и ручных шагов между коммитом и продакшеном
Действия
Content collections с Zod-схемами, withBase() для base-path, inline-скрипт темы без flash, SEO-набор, деплой на Pages по push
Результат
Невалидный frontmatter ломает сборку, а не деплой; ни одна ссылка не хардкодит base; новый проект — без правки кода
AstroTypeScript +2