ClickHouse — десять SQL-кейсов на 50 млн строк
Ситуация
ClickHouse легко показывает красивый план запроса и легко же врёт: диалект отличается от привычного SQL, uniq возвращает оценку, а avg(amount) по событийной таблице считает не средний чек. Кейсы, собранные «на глаз», выглядят убедительно и расходятся с данными при первом же пересчёте.
Отдельная проблема — оптимизация. Если переписать запрос и добавить проекцию одновременно, выигрыш нельзя приписать ни одному из изменений.
Задача
Мне нужно было собрать лабораторию, где каждый кейс сверяется со снапшотом и независимым движком, а выигрыш оптимизации измеряется при неизменном тексте запроса.
Действия
Данные. Сгенерировал 50 000 000 событий: пользователи, товары, каналы, суммы. Таблица MergeTree партиционирована по месяцу и отсортирована по (event_date, user_id); seed фиксирован, размер parquet — около 600 МБ.
Десять кейсов. Воронка через windowFunnel, retention по когортам, сессии с правилом 30 минут, gaps-and-islands, LIMIT BY, LTV по когортам, атрибуция argMin/argMax, RFM, приблизительный uniq и десятый кейс — оптимизация.
Кросс-проверка движков. Для семи кейсов написал DuckDB-двойник: тот же вопрос, другой движок. Если ответы расходятся, это сигнал о семантике диалекта, а не о «правильном» движке. Допуски заданы явно: абсолютный 0,01 и относительный 1e-9.
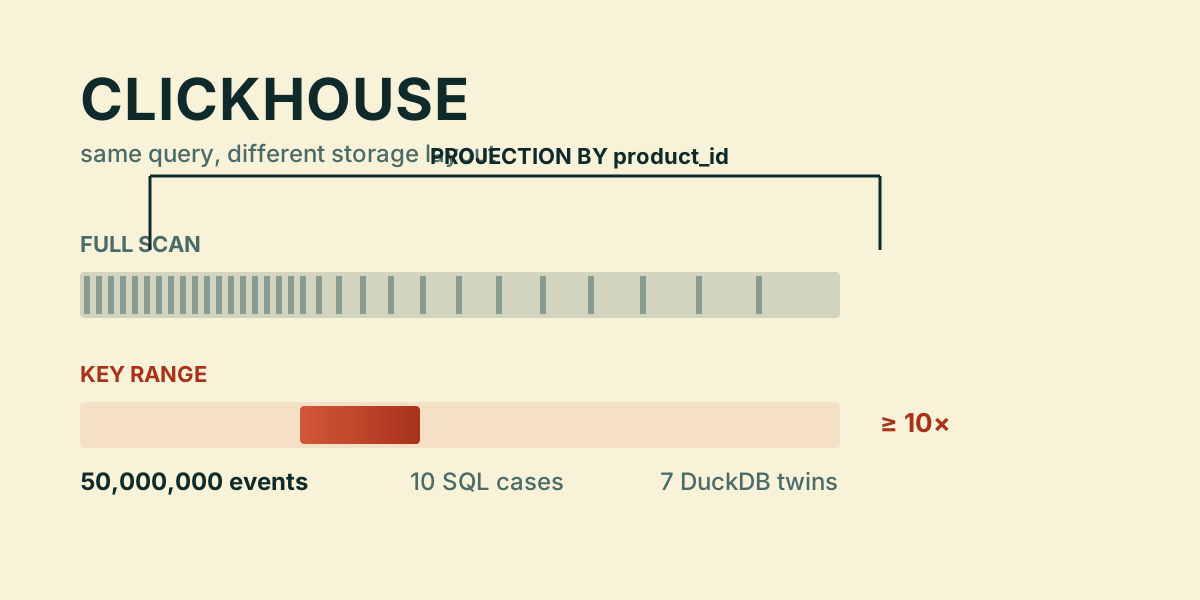
Оптимизация без переписывания. Оставил slow.sql и fast.sql побайтово идентичными — это проверяет тест, а не комментарий. Единственное изменение — ADD PROJECTION ... ORDER BY product_id, после чего тот же запрос читает диапазон ключа вместо полного скана.
Отрицательные результаты. Проверил PREWHERE и bloom_filter: первый ClickHouse применяет сам, второй бесполезен, потому что порядок вставки случаен относительно product_id и пропускает почти каждый гранул. Оба вывода записаны в кейс.
Проверки. 56 статических тестов работают без Docker: они связывают ключи снапшота, SQL-файлы и резолвер run.py, запрещают модульные skipif и проверяют идентичность slow и fast SQL. Три интеграционных теста требуют живой сервер и пропускаются без него.
Результат
- Объём: 50 000 000 событий; доля покупок 0,1800 (9 001 288 событий типа 4), средний платёж 252,54.
- LTV по когортам: крупнейшая когорта — 810 757 пользователей, 81,3% платящих, LTV-30 на пользователя 418,81, AOV-30 среди платящих 515,17.
- Приблизительный
uniq: 1 001 936 против точного 1 000 000, ошибка 0,1936%. - Сессии: 49 711 224 сессии по правилу 30 минут.
- Кросс-проверка: снапшот и семь DuckDB-двойников сходятся в пределах заданных допусков.
- Оптимизация: slow и fast SQL идентичны, проекция проходит порог ускорения ≥10× на полном скане.
- Тесты: 56 статических без сервера и 3 интеграционных; CI отдельно проверяет, что
expected.jsonне выпал из репозитория.
Ограничения
Датасет — бенчмарк-фикстура, а не бизнес-данные: каналы и товары не несут сигнала, корреляции с суммой близки к нулю. Кейсы проверяют корректность SQL и схемы, а не продуктовые выводы.
amount структурно раздут нулями: 82,0% значений равны нулю, а ненулевые совпадают с покупками. Поэтому avg(amount) — не средний чек; это ограничение записано в README.
data/seed.parquet не коммитится, весит около 600 МБ и пересобирается локально. Снапшот expected.json снят раньше текущей версии генератора, поэтому после удаления parquet числа могут сдвинуться — это известное ограничение кейса, а не гарантия вечной воспроизводимости.
Интеграционные тесты пропускаются без Docker, поэтому CI не проверяет ни снапшоты, ни ускорение. EXPLAIN до и после и clickhouse-benchmark p50/p95 не приложены: в кейсе зафиксирован порог ускорения, а не измеренная кривая.
Документация
README.md— десять кейсов, цифры и границы применимости.cases.md— разбор каждого кейса: вопрос, запрос, результат, что он доказывает.- Быстрый старт:
docker compose up -d→uv sync --all-groups→uv run python scripts/seed.py→uv run python scripts/run.py. - Без сервера:
uv run python scripts/run.py --duck-only— DuckDB-двойники против снапшота.