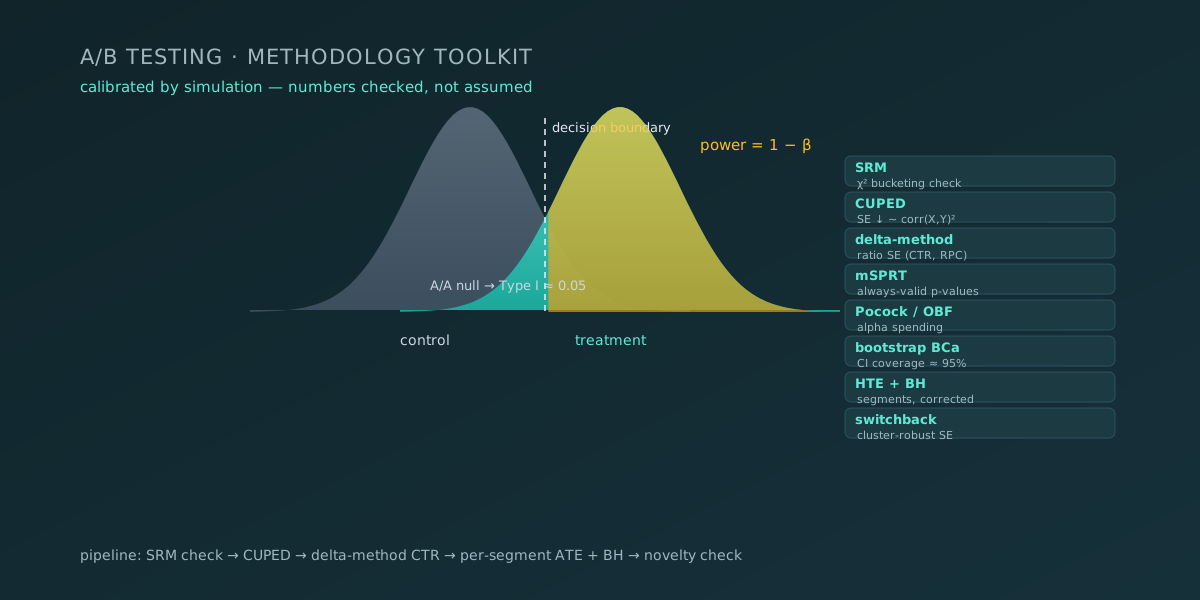
A/B Testing Methodology Toolkit
15 модулей A/B-методологии, каждый откалиброван симуляцией: A/A-тест держит Type I error на уровне α, power-кривые показывают реальную мощность.
PythonNumPy / SciPypytestuv
Эффект: 15 модулей, каждый откалиброван симуляцией: Type I error ≈ α, power-кривые, CUPED: SE сжимается в ~corr(X,Y)² раз, Наивный peeking раздувает Type I error — Pocock/OBF и mSPRT держат его под контролем, Delta-method даёт корректный SE для ratio-метрик (CTR, RPC) — наивный per-unit t-test смещён, End-to-end pipeline: SRM → CUPED → delta-method CTR → сегментные ATE + BH → novelty check
Reporting Automation Telegram Bot
Telegram-бот заменил ручную подготовку недельного отчёта на cron: 1–2 часа работы вручную превратились в отчёт по расписанию с KPI-таблицей и спарклайнами.
Pythonaiogram / telegram-botSQLcron schedulerTableau
Эффект: Cut weekly report prep from 1–2h to automated cron, KPI table + sparklines delivered on schedule, Fallback notifications on source failures, Single consolidated pipeline replacing fragmented sources
Causal / Uplift — CUPED and Individual Treatment Effects
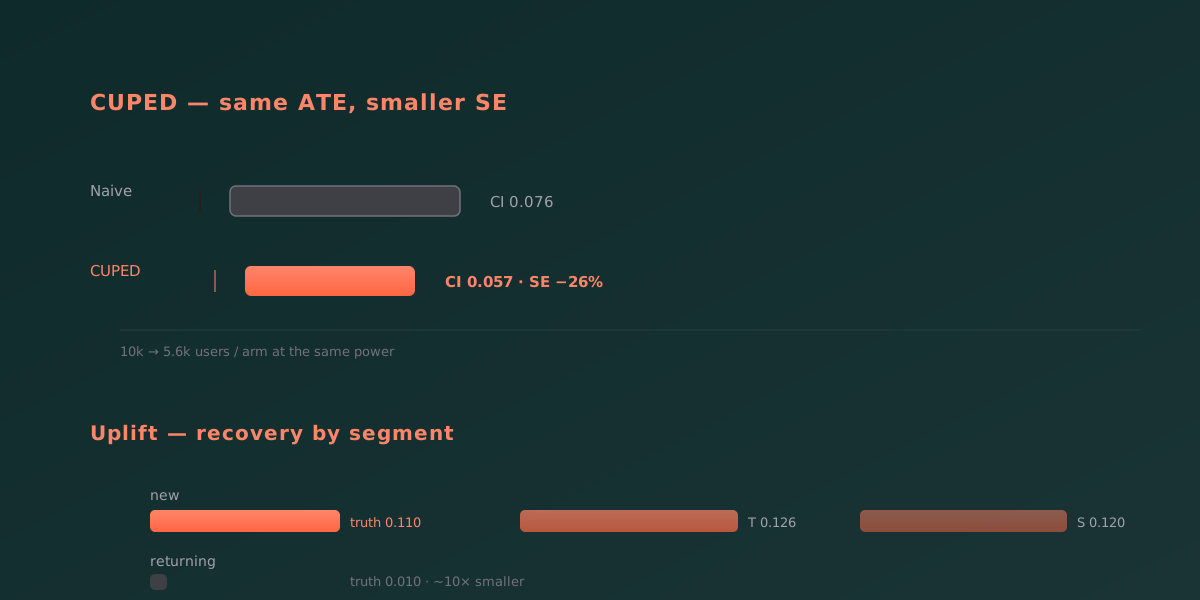
CUPED срезал стандартную ошибку на 26%: та же мощность достигается на 5,6k пользователей на руку вместо 10k. Uplift-модели восстановили известный гетерогенный эффект с нуля.
PythonLightGBMscikit-learnpandas / NumPymatplotlibpytestuv
Эффект: CUPED keeps the ATE (0.270 → 0.276) and cuts the standard error ~26%, Same power with ~5.6k users/arm instead of 10k (95% CI narrows 1.35x), Uplift models recover that new users respond ~10x more than returning users, Implemented from scratch on LightGBM — no causalml/econml dependency
Churn Prediction — Leakage-Free Retention Model
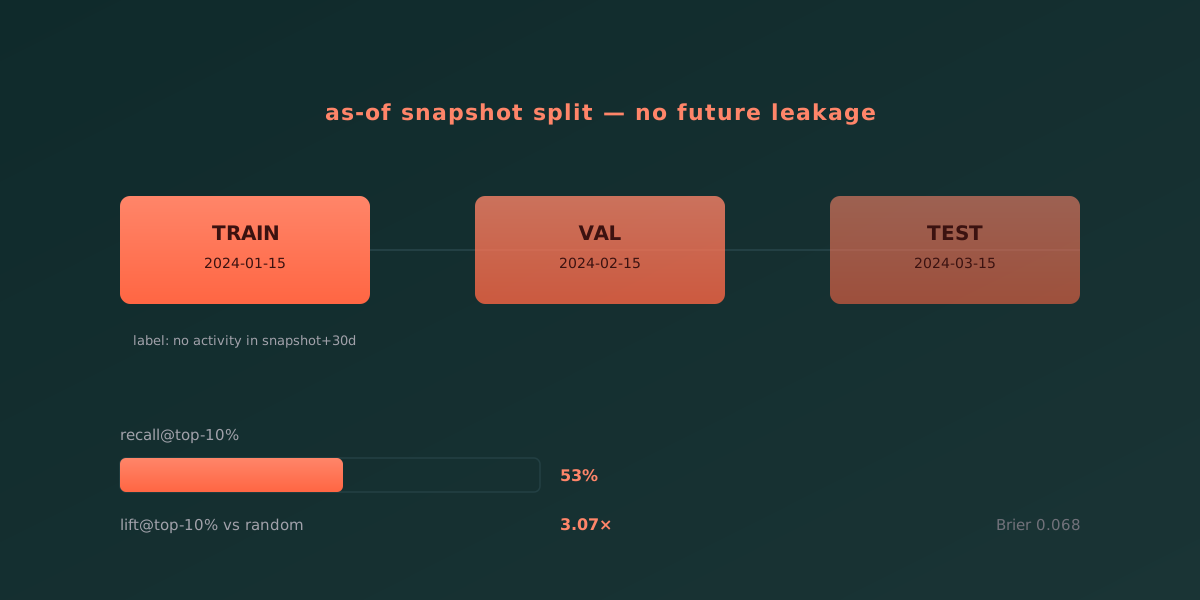
Leakage-free churn-модель: recall@top-10% = 0.53 и lift 3,07× при ROC-AUC 0.904 на хронологическом сплите — без утечки будущей активности в признаки.
PythonLightGBMscikit-learnpandas / NumPymatplotlibpytestuv
Эффект: Chronological snapshot split (train/val/test) — no future activity leaks into training, Churn label = a future 30-day inactivity window for recently active users only, Decision metric recall@top-10% = 0.53, lift@top-10% = 3.07x, LightGBM Brier 0.068 vs 0.099 for the balanced logistic baseline
Cohort Analysis Dashboard
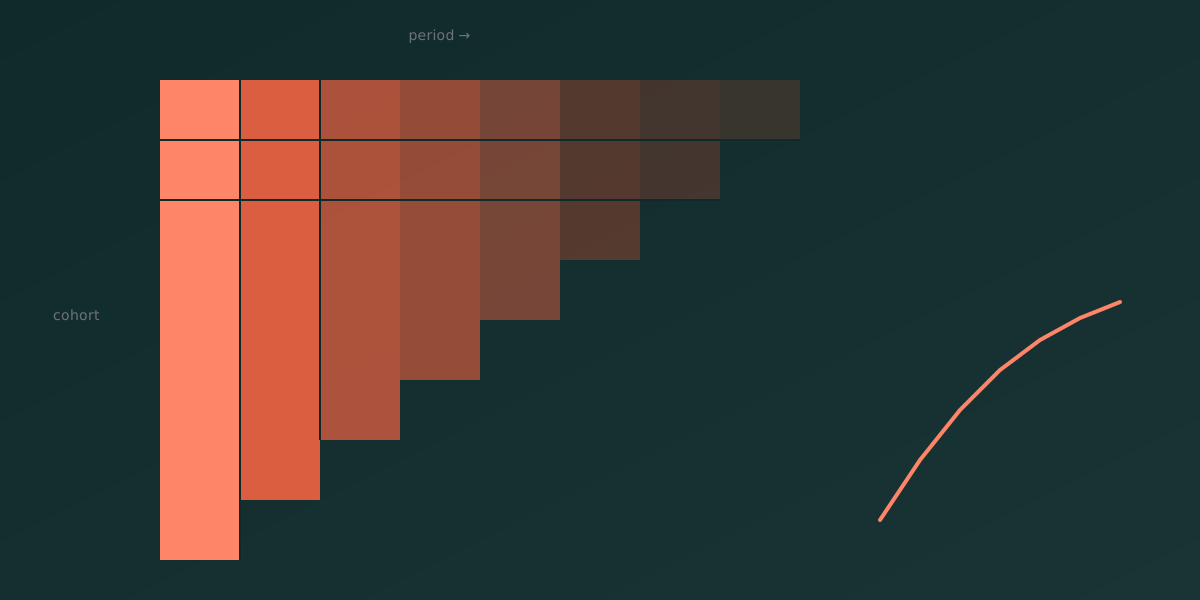
Треугольная когортная матрица удержания и LTV на синтетических данных: ARPU и LTV по когортам с поправкой на observation age, выгрузка в Tableau (CSV + Hyper).
Pythonpandasmatplotlib / seabornJupyter NotebookTableau (Hyper API)
Эффект: Cohort retention matrix with triangular decay, ARPU / LTV by cohort with proper observation-age caveat, Tableau-ready export (CSV + .hyper extract), Reproducible seeded pipeline (seed=42)
TaskFlow — PostHog Product Analytics Pipeline
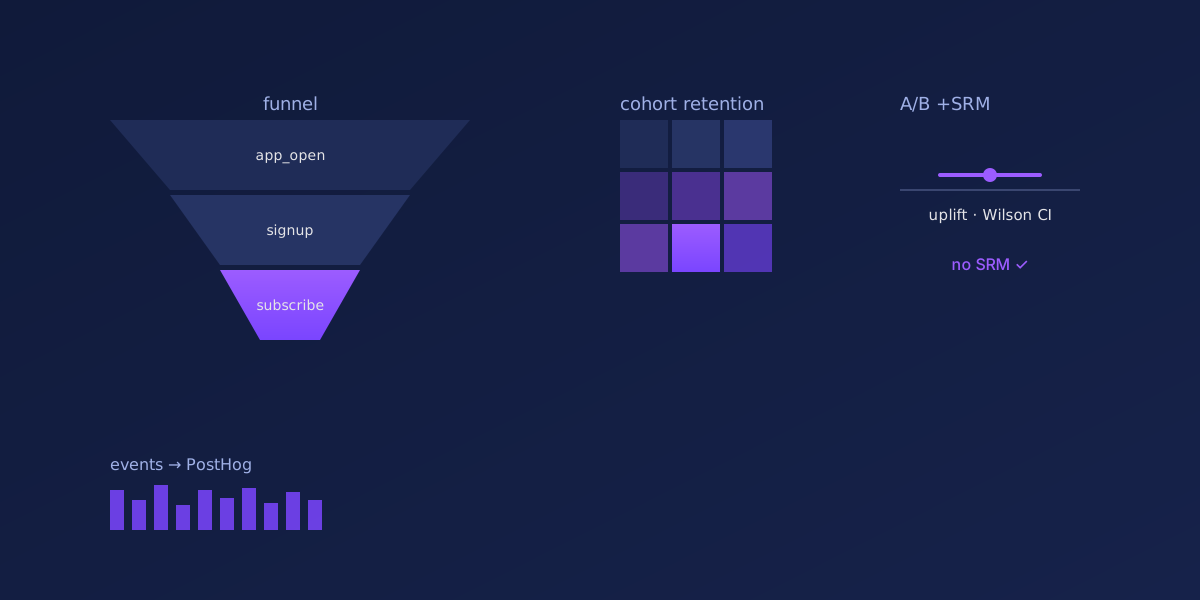
SaaS-продукт, инструментированный PostHog end-to-end: типизированный каталог событий, генерация трафика и 7 анализов — воронка, retention, A/B, revenue/LTV, time-to-convert.
PythonPostHogFastAPIStreamlitpandas / matplotlibpytest / ruffDocker
Эффект: Typed event catalog (single source of truth) + PostHog capture/identify/group with PII scrubbing, Feature flag → onboarding A/B variant; A/B analysis with chi-square, uplift, Wilson CI + SRM check, Day-N cohort retention, time-to-convert, revenue/LTV, first-feature → upgrade conversion, The same metrics as SQL (BI / interview reference) + interactive Streamlit dashboard, CI (pytest + ruff) + Docker + render.yaml for one-click deploy
Python Analytics Playground
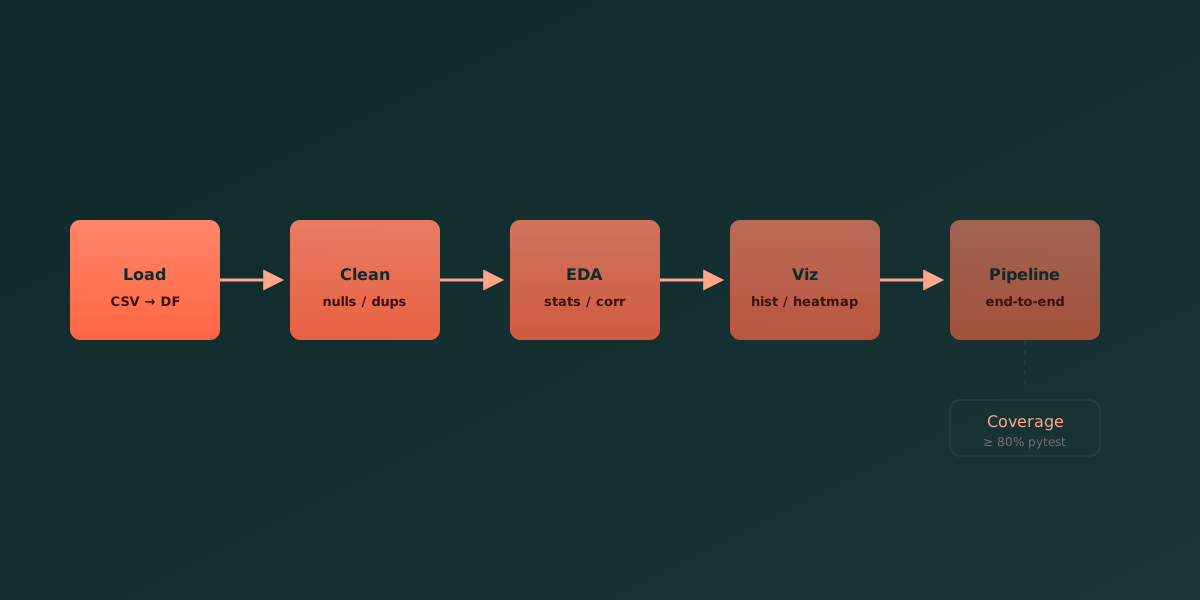
Модульный Python-тулкит для аналитики — загрузка, чистка, EDA, визуализация — собранный в один пайплайн с покрытием pytest ≥80%. База, которую я копирую в каждый новый анализ.
Pythonpandas / NumPyMatplotlibpytestuv
Эффект: Modular load / clean / EDA / viz / pipeline modules with pytest coverage ≥80%, Single end-to-end pipeline runnable as `python -m python_analytics`, Requirements traced to a PRD (REQ-002 … REQ-006), tests tied to requirements, uv + ruff tooling, synthetic data for demo runs
RFM Analysis of Bank Clients
Разбил клиентскую базу банка на 4 RFM-сегмента и показал, что малая доля high-value приносит основную выручку. Маркетинг перешёл от массовых рассылок к сегментированным сценариям.
PythonSQLTableau
Эффект: Identified high-value customer segments, Optimized marketing campaigns, Improved retention efficiency
Sales Calls Analytics Dashboard
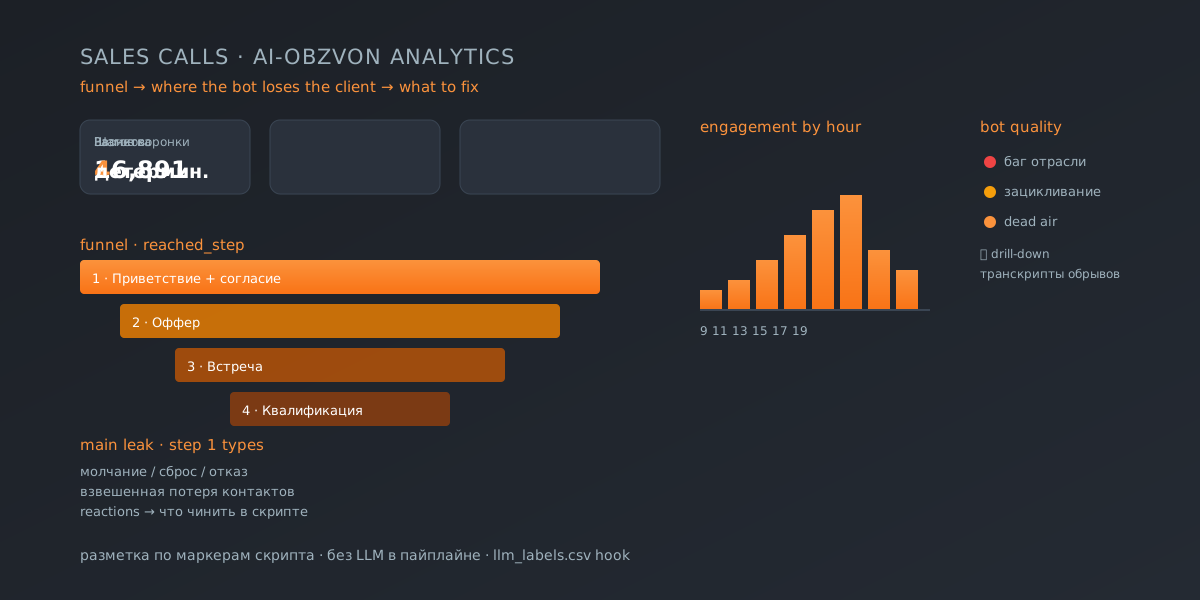
Streamlit-дашборд ИИ-обзвона на 16 891 синтетическом звонке: 4-шаговая воронка (приветствие → оффер → встреча → квалификация), разбор утечки по типам и drill-down в транскрипты.
PythonStreamlitpandas
Эффект: 16 891 синтетический звонок, разметка детерминированная (маркеры скрипта), 4-шаговая воронка: приветствие → оффер → встреча → квалификация, Главная утечка разбирается по типам (молчание / сброс / отказ) + взвешенная потеря контактов, Вовлечённость по часам и дням недели — когда звонить, Хук под LLM-разметку реакций (llm_labels.csv) — пайплайн воспроизводим и без него
SQL Analytics Case Study
25 SQL-кейсов на синтетическом датасете (~183k событий): воронка, retention, LTV, атрибуция, аномалии. Запуск на DuckDB одной командой, живой отчёт на GitHub Pages.
SQLDuckDBPythonpandas / NumPypytest
Эффект: 25 self-contained SQL cases (funnel → RFM), DuckDB — no server, no credentials, one command, Regression tests with deterministic invariants per case, Synthetic deterministic data (seed=42 + additive seed=43), Live interactive report on GitHub Pages
Product Analytics Dashboard (Streamlit)
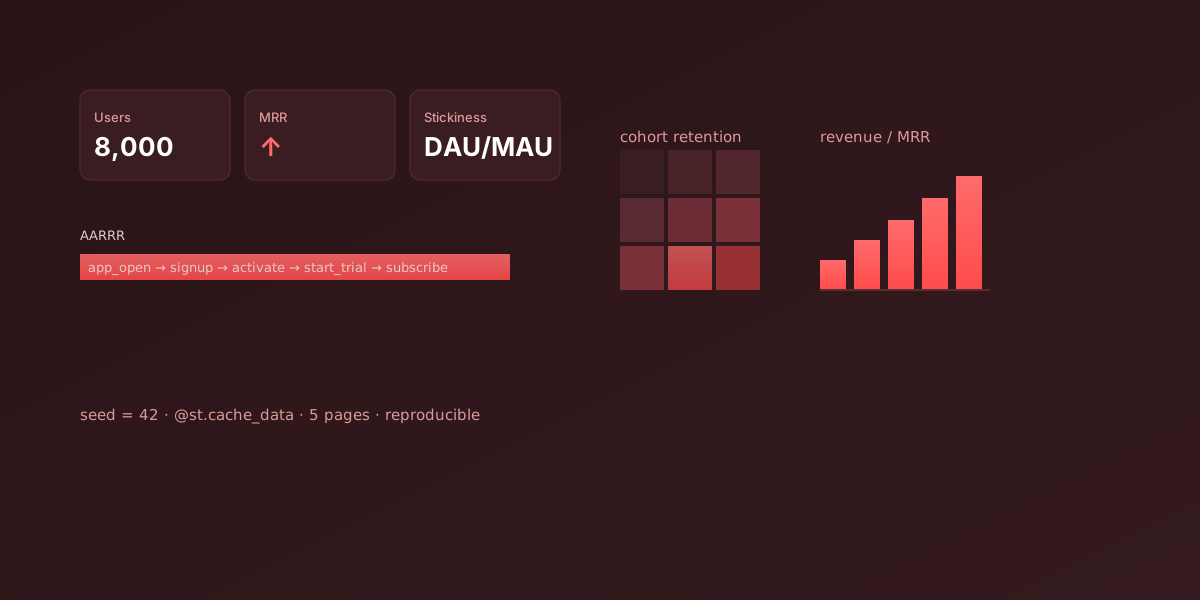
Продуктовый дашборд на синтетическом SaaS-датасете (8 000 пользователей): AARRR-воронка, cohort retention, выручка (MRR, ARPU, churn) и сегментация — 5 страниц на Streamlit.
PythonStreamlitpandas / NumPy
Эффект: 8,000 synthetic users, Jan 2024 – Jun 2025, deterministic seed = 42, AARRR funnel: app_open → signup → activate → start_trial → subscribe with step drop-off, Cohort retention heatmap (signup month × months since signup), Revenue: MRR growth, MRR by plan, ARPU, logo churn, Segments: distributions + conversion + ARPU by segment / channel / country / device
Product Analytics + A/B on Supabase
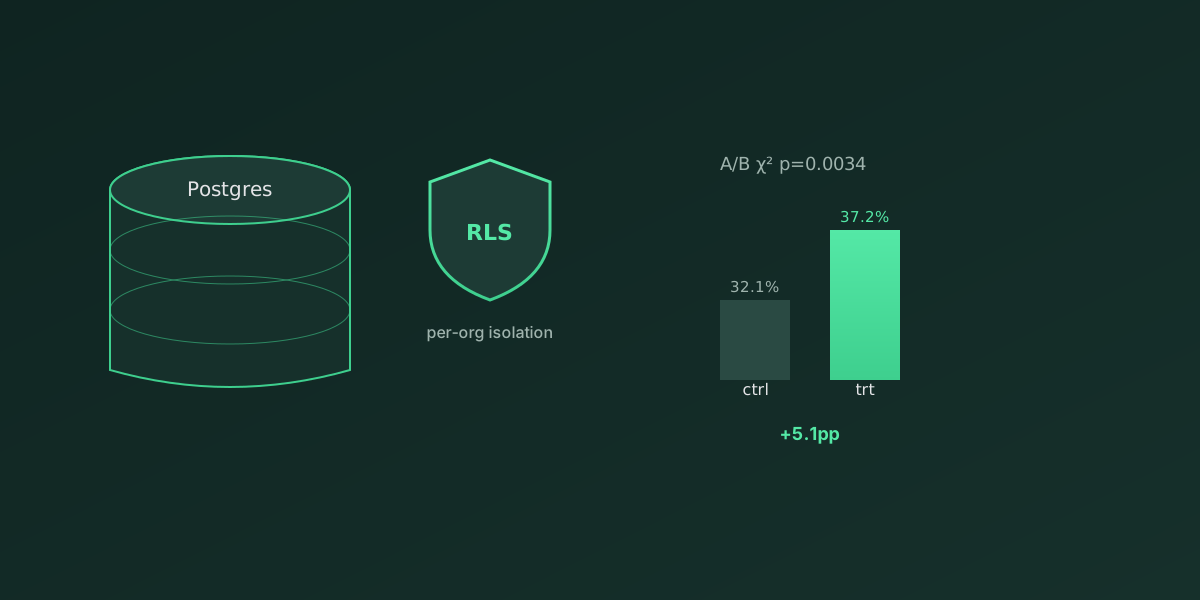
Full-stack аналитика на Supabase: A/B-эксперимент дал +5,1 пп (p = 0.0034, chi-square), а Streamlit-дашборд читает живые данные через Row Level Security и SQL-вьюхи.
PythonStreamlitSupabase (Postgres + RLS + Edge Functions)SQLsupabase-py
Эффект: Full-stack: Streamlit UI + Supabase Postgres + Edge Function ingest (API-key auth), Row Level Security on every table — a user sees only their org's rows, SQL views compute funnel, cohort, MRR, DAU, channel conversion — the dashboard reshapes, it does not aggregate, A/B result in the DB: control 32.1% vs treatment 37.2%, p = 0.0034 (chi-square)
Volta Neobank — Product Analytics
Нашёл узкое место в онбординге необанка и закрыл A/B-тестом: +5,72 пп конверсии KYC и €656K в год. 17 аналитических проектов на синтетических данных.
Pythonpandas / NumPySciPy / Statsmodelsscikit-learnMatplotlib / Seabornuv + ruff
Эффект: +5.72pp KYC conversion (Z=5.82, p<0.0001), €656K/yr (44× ROI), +9.2pp M3 retention, +€227K/yr incremental LTV, 4 data-driven user segments with per-segment monetization strategy, CUPED variance reduction + AA-test (type-I = 0.050) + Bonferroni correction