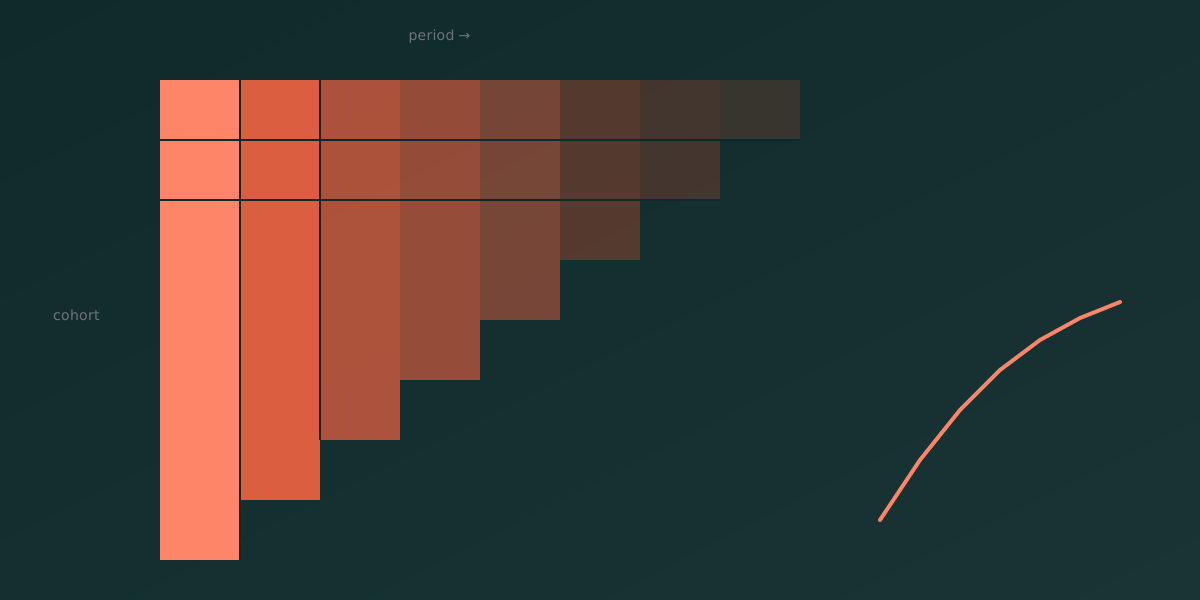
Cohort Analysis Dashboard
Ситуация
Когортный анализ удержания и LTV на синтетических данных: удержание пользователей, кривые оттока и выручка по когортам прихода. Средний retention прячет динамику, а LTV без поправки на возраст когорты вводит в заблуждение. Задача — собрать матрицу, на которой видно, где скорость оттока выше и где монетизация падает быстрее удержания. Пайплайн на Python (pandas + matplotlib/seaborn), плюс выгрузка для Tableau; данные детерминированные (seed=42), воспроизводятся из кода.
Задача
Мне нужно было сделать так, чтобы по данным было видно поведение каждой когорты отдельно, а не сглаженная средняя по всей базе.
Действия
Модель данных — одна строка = «пользователь × месяц наблюдения»:
| Поле | Тип | Описание |
|---|---|---|
user_id |
int | идентификатор пользователя |
cohort_month |
date | месяц прихода (выводится из join_date, не отдельное поле) |
join_date |
date | дата регистрации (первое число месяца) |
period |
int | месяцев с прихода (0 = месяц регистрации) |
is_active |
int 0/1 | активен ли в этом месяце |
revenue |
int | выручка за месяц (0, если не активен) |
cohort_month выводится из join_date, как в реальном продакшене. Младшие когорты наблюдались меньше месяцев — матрица удержания треугольная.
Методология:
- Period 0 = 100% удержания по определению (все активны в месяц прихода). Кривая убывает с периода 1:
retention(p) = 0.85 · 0.75^(p-1). - Выручка: активный месяц →
Poisson(λ=10); неактивный → 0. - Размеры когорт — число уникальных
user_idвperiod == 0. - ARPU — средняя выручка на пользователя когорты; LTV — кумулятивный ARPU по периодам.
Функции: cohort_sizes() (приток по месяцам), retention_matrix() (матрица + кривые), revenue_by_cohort() (ARPU/LTV).
Tableau-выгрузка (tableau_export.py) создаёт в tableau/:
cohort_export.csv— плоский shape для Tableau (доб.cohort_labelиperiod_date— календарный месяц наблюдения);cohort_extract.hyper— Tableau Hyper-экстракт через официальный Hyper API.
Heatmap в Tableau: Columns = period, Rows = cohort_label, Marks = Square, Color = AVG(is_active), Text = % of Total по строке.
Результат
Когортный вид важнее среднего retention: на нём видно скорость оттока и монетизацию относительно удержания. Ключевые решения по методологии — cohort_month выводится из join_date (а не отдельным случайным полем), period 0 = 100% по конвенции, NaN замаскированы в heatmap вместо рендера nan%.
Ограничения
LTV младших когорт занижен из-за короткой истории — сравнивать LTV корректно только при равном «возрасте» когорты. Данные синтетические, поэтому числа иллюстрируют метод, а не поведение реального продукта.