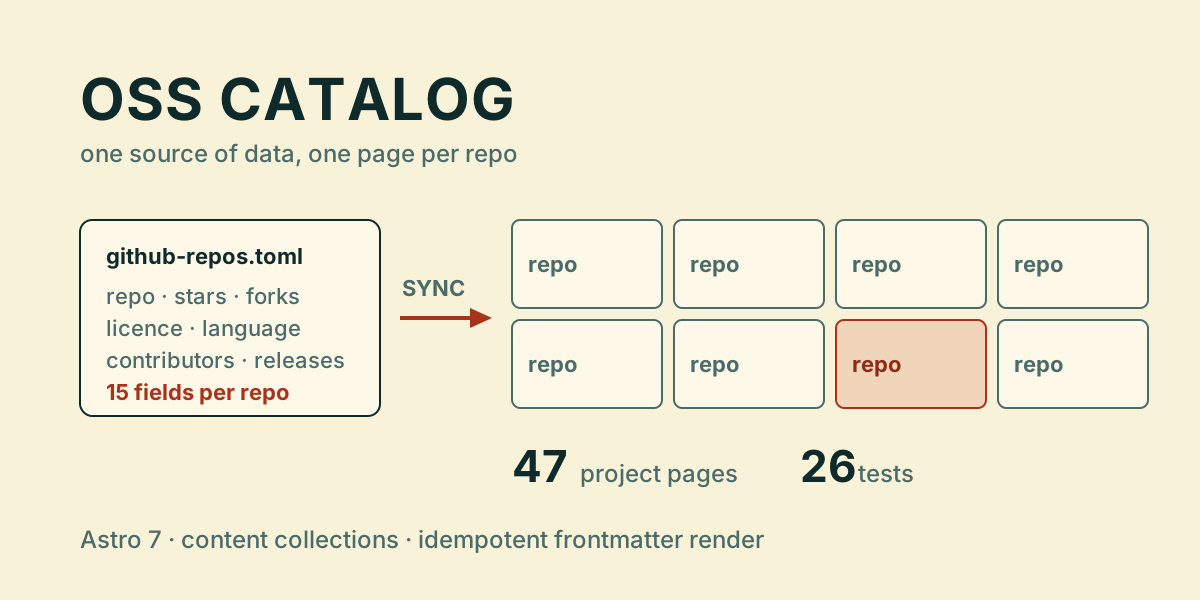
OSS-каталог — 47 проектов из одного источника
Ситуация
Каталог открытых проектов, собранный вручную, стареет быстрее, чем его успевают обновлять. Звёзды, релизы и языки меняются на GitHub, а на сайте остаются числа месячной давности. Хуже того, одна и та же карточка существует в двух местах — в таблице данных и в разметке — и расходится с собой.
Задача
Мне нужно было сделать каталог, где данные приходят из одного машинного источника, страницы собираются из него, а повторная синхронизация не ломает ручные правки.
Действия
Источник данных. Python-скрипт обращается к GitHub API и пишет один TOML-файл: 47 записей по 15 полей — имя, описание, звёзды, форки, релизы, лицензия, язык, контрибьюторы, дата обновления и другие. Кэш ответов API лежит вне репозитория.
Разделение владения. Генератор переписывает только блок frontmatter под маркером «обновляется автоматически», остальное содержимое страницы остаётся авторским. Поле exclude: вырезает шумные машинные значения, а явно заданные языки переживают повторный синк.
Сборка. Astro 7 с content collections: glob-лоадер читает страницы проектов и заметок, схема Zod проверяет типы, а страница проекта рендерит метаданные и ссылки. Сайт статический, клиентского фреймворка нет.
Валидация. Отдельный валидатор проверяет заметки и страницы проектов: обязательные поля, совпадение ключей с источником, отсутствие пустых блоков. В строгом режиме предупреждение о записи без метаданных становится ошибкой.
Тесты. 26 тестов покрывают три ветки сопоставления записей — owner/name, короткое имя и имя каталога, — идемпотентность рендера, сохранение редакционных полей и реальное дерево страниц.
CI. Порядок шагов выбран по стоимости: валидатор и Python-тесты идут до установки зависимостей Astro, затем astro check, сборка, Pagefind и деплой. Дешёвый гейт падает раньше дорогого.
Результат
- 47 страниц проектов и 47 записей репозиториев из одного TOML-файла.
- 15 полей метаданных на запись, включая звёзды, форки, релизы, лицензию и дату обновления.
- 26 тестов, включая побайтовую идемпотентность повторного рендера.
- 8 тематических страниц, 76 страниц тегов и 5 страниц языков генерируются из того же источника.
- Сборка не ходит в сеть: сайт читает только закоммиченный frontmatter, поэтому деплой воспроизводим.
- Валидатор проходит на всех страницах, а
astro checkловит расхождения схемы до сборки.
Ограничения
Валидация механическая: дрейф описаний, плейсхолдеры и alt-текст остаются на человеке или отдельном редакторском проходе.
Тест на количество страниц проверяет нижнюю границу, а не точное число, поэтому дрейф от 47 остаётся зелёным.
website, readme_image, latest_release и first_commit собираются или объявлены в схеме, но не рендерятся: поля есть, потребителя нет.
Pagefind устанавливается и запускается в сборке, но поискового интерфейса на сайте нет — поиск остаётся неиспользованной зависимостью.
Каталог — витрина инженерного пайплайна, а не продукт с метриками: пользовательской аналитики и A/B-тестов здесь нет.
Документация
README.md— источник данных, быстрый старт и границы применимости.scripts/update-github-repos.py— синхронизация GitHub API в TOML.scripts/update-project-frontmatter.py— генератор блока метаданных с маркером владения.- Проверки:
bun run validate→uv run tests/test_scripts.py→bun run check→bun run build.