2 день программы: 37 докладов в 5 залах. Время указано по Москве; сетка повторяет страницу первоисточника, но собрана на билде.
Длительность
3 дня
Доклады
91 доклад
Треки
11 треков
Залы
9 залов
37докладов
Расписание докладов
Время
Молекула
Атом
Архангельск
Физика
Кинетика
10:20
10:20 - 10:55Молекула
Беслан КурашовCo-founder и chief AI officer, Plevako.Ai
Методы работы с чувствительными данными: какие данные бывают, какие методы подходят для каждого случая, как подобрать правильный метод и где всё это может поломаться. Разбираемся, как (и что) не разрешать провайдерам делать со своими данными. Подробно поговорим о том, как использовать LLM в ситуациях, когда может быть задействовано много чувствительных данных и как при этом не допустить утечек, успокоить службу безопасности, релизнуть сервис и не разориться на железках. Слушатели получат ответы на вопросы: как эффективно использовать LLM, чтобы не обучать провайдера, не нарушать законы, не привлекать регуляторов и дружить со службой безопасности; что делать, если мы хотим крутить нейронки у себя (on-premise)? Как «манипулировать» данными с целью устранения чувствительности, но сохранения сути? Как сшить пайплайны под задачу, балансируя между приватностью и мощностью? Как создать «шоры» для LLM, чтобы не отдать управление пользователям?
10:20 - 10:55Атом
Галина БлонскаяМенеджер продукта, Яндекс
Новая модель данных позволяет сделать гибкое окно атрибуции, связать медийные показы с целями Метрики и событиями AppMetrica, добавить новые параметры и метрики качества трафика.
10:20 - 10:55Архангельск
Анна КоковинаМенеджер продукта, Yandex AI Studio
Превращаем цепочку аналитических действий в автоматизированный процесс: формирование запросов, анализ динамики и использование результатов для проверки продуктовых и маркетинговых гипотез. Как устроен многошаговый поисковый агент, который формирует запросы, изучает результаты, возвращается к поиску и собирает информацию из множества источников и как превратить типичный competitive research из ручного процесса в повторяемый агентский ресёрч.
10:20 - 10:55Физика
Андрей КоролевДиректор по аналитике, Т-Банк
Качество клиентского сервиса — это управляемый экономический параметр, а не просто набор операционных SLA. В Т-Банке провели масштабный A/B-тест, отказавшись от единого стандарта поддержки: для разных сегментов применили режимы жесткой экономии (ECO, −30% костов) и премиального саппорта (CX+, +70% костов). Эксперимент доказал, что инвестиции в качество окупаются далеко за пределами контакт-центра: режим CX+ статистически значимо растит NPV, повышает утилизацию продуктов и даже снижает долю просрочек по кредитам. Разберем механику оценки через прокси-метрики LTV и покажем, как дифференцировать сервис, чтобы безопасно резать косты и максимизировать совокупную прибыль
11:00
11:00 - 11:35Молекула
Николай ГоловДиректор по продукту Tengri Data, ex-Авито
Риски современных законов о защите персональных данных (GDPR, 152 ФЗ, CCPA, PDPA, PDPL, DPDPA) в контексте использования внешних AI моделей. Насколько легально слать во внешние API AI сервисов персональные данные? Насколько реально защититься от рисков за счет обфускации отправляемых данных? Разбираем риски, возможности, и надежность такой защиты
11:00 - 11:35Атом
Олеся НорицынаData scientist, CUBE
Пошаговая инструкция по сборке Bayesian MMM для «флайтовых» размещений и чеклистом диагностики модели. Разбор работы с эффектом затухания памяти о рекламе (adstock) и убывающей отдачей от вложений (saturation)
Система AI-агентов вокруг A/B-платформы и измерение её надёжности через benchmark на основе mutation testing: вносим контролируемые дефекты в кейсы с известным ответом и считаем mutation score, false positive rate и порог обнаружения. На этом полигоне сравниваем модели и архитектуры и определяем границы допуска где агентам уже можно доверять
11:00 - 11:35Физика
Дмитрий ПавловАналитик, Яндекс.Драйв
Имитационная модель системной динамики, откалиброванная под фактические бизнес-метрики, отвечающая на вопрос что будет с метриками если варьировать параметры бизнеса.
11:00 - 12:10Кинетика
Денис ПлатоновCEO, Excite Kit
Александр СорокинПрофессор, д.э.н и основатель «Центра Статистического Анализа».
Участники пройдут цикл от разметки действий пользователя, до формирования продуктовых гипотез и запуска АБ-теста на реальном ecom-клиенте платформы uxrocket.ru Участники также выполнят пост-анализ и научатся формировать гипотезы, которые в 3 раза чаще приводят к росту.
11:40
11:40 - 12:10Молекула
БЕЗОПАСНОСТЬ ИИМолекула
Где персональные данные появляются в LLM-продукте? Чем различаются внешний API, российский посредник и самостоятельное размещение открытой модели. Как установить фактических получателей данных и страны обработки. Правовые основания обработки, локализация, уведомления по статьям 12 и 22, договоры и распределение ответственности. Какие сведения нужно получить от поставщика и что делать, если он не раскрывает необходимые условия. Что происходит с правовым статусом данных после удаления ФИО и телефонов. Как учитывать косвенную идентификацию, сохранённую таблицу соответствий и возможность восстановления сведений из контекста. Хранение запросов и ответов, использование данных для обучения, доступ сотрудников, привлечение других обработчиков, удаление информации и действия при инцидентах. Разборы типовых продуктовых сценариев и пограничных случаев (например, модель размещена внутри компании, но отдельные компоненты распознавание речи, получение эмбеддингов или журналирование — используют внешние сервисы. Как в этом случае оценить систему целиком)
11:40 - 12:10Атом
Максим КочуровДиректор, Вероятностные решения
Обсуждаем идентифицируемость, смещение и принятие решений в условиях неопределенности. Байесовская нелинейная эконометрика позволяет оценить причинно следственные связи и составление модели будет в теме нашего разговора: как составить модель таким образом, чтобы они действительно была не только интерпретируемой, но и идентифицируемой, как параметризовать модель, чтобы при оценке она не развалилась, а смещение было побеждено, как принимать решения в условиях неопределенности и чем нам поможет теория стохастической оптимизации.
11:40 - 12:10Архангельск
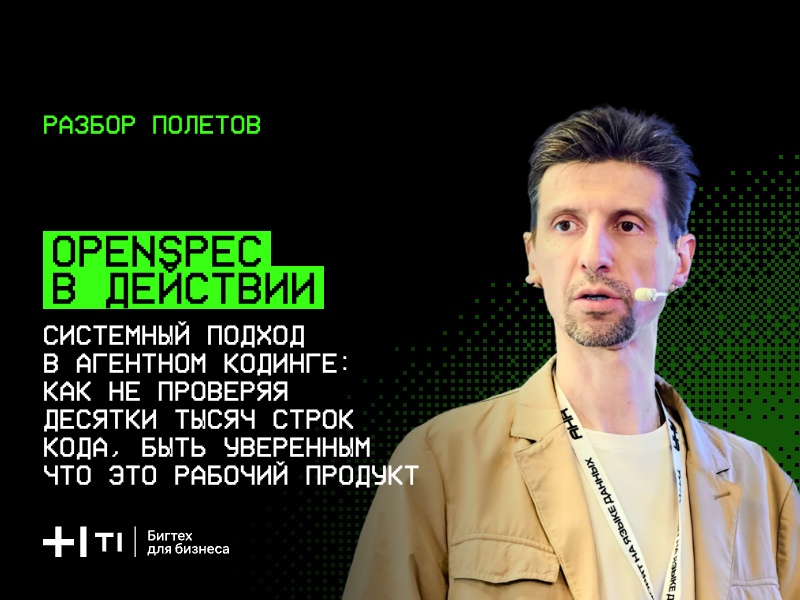
Сергей БажинГлавный аналитик данных, ИТ-холдинг-Т1
Рабочая связка open-source инструментов для агентского кодинга. Методология разработки OpenSpec и OpenSpec+. Превращаем хаотичную генерацию в предсказуемый и контролируемый инженерный процесс.
Разделить селлеров на группы А и Б в нашем случае нельзя: это означало бы предоставление разным селлерам разных условий продвижения. Поэтому провести классический A/B-тест невозможно. Решением становится синтетический контроль: он позволяет оценивать эффект изменений без прямого разделения селлеров на тестовую и контрольную группы
12:15
12:15 - 13:20Молекула
Алексей ЛукацкийChief Evangelist Officer, Positive Technologies
Запретить ChatGPT проще, чем научиться с ним безопасно работать. Главный ИБ-евангелист Positive Technologies Алексей Лукацкий рассказывает, как российские компании выстраивают секьюрную работу с западными LLM. В рамках лекции разберем методы анонимизации данных, архитектуру AI-firewalls и главное — как продуктовому аналитику научиться договариваться с отделом кибербезопасности, чтобы любимая фраза «ИБ это не пропустит» стала началом продуктивного диалога, а не крестом на внедрении ИИ.
12:15 - 12:45Атом
Максим КалацкийCAO Adtech, Магнит AdTech
Когда утилизация на пике, вы не можете показать бизнесу кратный рост, а партнерам — дать нужные объёмы за счёт свободного трафика. Делимся методологией расчета утилизации, подходами к медиапланированию и способами охлаждения трафика.
12:15 - 12:45Архангельск
Екатерина ГерасименкоTechnical product manager, MAGNIT TECH
Перенос работы из ручных передач и однотипной разработки в конфигурацию, генераторы и инструменты платформы. Это сокращает путь от описания источника до появления данных в платформе и позволяет масштабировать подключение типовых источников без пропорционального роста ручной работы.
12:15 - 12:45Физика
Марк ХабаровРуководитель команды ML-аналитики, VK (Дзен)
МА
Мария АвдееваСтарший технический аналитик, VK
Как глубокий анализ аудитории А/В-теста помогает находить неожиданные эффекты экспериментов, принимать более точные продуктовые решения, а также улучшать качество и точность рекомендаций.
12:15 - 13:20Кинетика
Евгений КузнецовHead of analytics, JetStyle
Превращаем AI из генератора кода в управляемого исполнителя, способного провести задачу от размытого бизнес-вопроса до проверяемого результата.
12:50
12:50 - 13:20Атом
Максим КоматовскийРуководитель группы аналитики, Яндекс
Метрика, на которую бизнес хочет повлиять и метрика, на которую бизнес может повлиять произвольным воздействием - обычно разные метрики. Разбираем, как построить здоровое итерирование по продуктовым гипотезам с помощью графа метрик. Слушатели узнают, как извлечь больше информации из совокупности экспериментов - что дополнительно можно узнать о пользователях, если посмотреть на всю совокупность экспериментов, а также то, как измерять и декомпозировать эффект набора маркетинговых изменений на бизнес-метрику, когда ни один эксперимент в отдельности не даёт ответа.
12:50 - 13:20Архангельск
Фёдор ХолькинDatawarrior
Решение задачи устранения хаоса в данных компании и создание корпоративного графа знаний Последовательность перехода от исправления конкретной аналитической проблемы к общему контексту для AI-инструментов. Доклад поможет оценить, какие знания нужно формализовать в своей компании, как проверять их качество и с какого рабочего процесса начинать внедрение.
12:50 - 13:20Физика
Андрей РомановAnalytics team lead, Авито
Специфика тестирования AI-копайлотов и других внутренних продуктов и процессов компании, чтобы точно ответить на вопрос «изменил ли новый инструмент работу сотрудников достаточно сильно, чтобы его было выгодно масштабировать».
13:25
13:25 - 14:30Молекула
Александр АбрамовКонсультант по ИИ, ВкусВилл
Александр МаерМетодолог по информационной безопасности, ТехВилл
Внедрение ИИ не защищает от утечек, если ради скорости пользователь копирует в промпт всю коммерческую тайну и выдает приложению доступ ко всему диску. В докладе разбирается архитектура ограничения доступа ИИ-сервисов к корпоративным данным и два механизма уязвимостей: открытые логи провайдеров и передача скрытых инструкций в активные сессии. Спикеры покажут, как выстроить «зеленый коридор» для типовых задач, внедрить паспорта ИИ-решений и тестировать безопасность через симуляцию рабочих процессов.
13:25 - 13:55Атом
Наталья ЦветковаРуководитель отдела анализа данных, Веборама
Денис ГнатенкоДиректор по продуктам, Веборама
Схема встраивания ИИ-агента в пайплайн обработки запросов с автоматическим контролем качества и важными точками проверки человеком. Разбираем архитектуру решения, логику автоматических тестов качества данных, типичные ошибки и эксплуатационные ограничения агента
13:25 - 13:55Архангельск
Александр БарышниковРуководитель отдела разработки корпоративного хранилища данных, Artenecy
Мы встроили в работу разговорного ИИ-помощника: сотрудник спрашивает о продажах обычными словами, текстом или голосом, и получает график или численный ответ. Права доступа наследуются из BI, ответ сверяется кодом, рядом с цифрой — её «паспорт» (период, фильтры, источник). На пойманном промахе модели покажу, как работает проверка, расскажу, что мы измеряем на пилоте и где бот ошибся. А дальше — о переходе к AI-native-аналитике: руководители сами работают с данными, их вопросы копятся в базу знаний, словарь метрик поддерживает бизнес, а аналитик становится архитектором системы, которая приносит гипотезы
13:25 - 13:55Физика
ТП
Тимур ПыгамовТ-Банк
МД
Максим ДянкинТ-Банк
Целостная модель интерференции (искажение результата из-за пересечения экспериментов) и оригинальный критерий оценки влияния одного эксперимента на другой и внутренний инструмент для оперативной проверки от команды ASL, развивающей внутреннюю АБ платформу Т-Банка.
13:25 - 14:30Кинетика
Сергей КукурузРуководитель стратегических проектов, Yandex AI Studio
Сборка агентских систем, выдающих результат стабильного качества. Инженерный разбор компонент и паттерны архитектуры ИИ-решений.
14:00
14:00 - 14:30Архангельск
Павел ДубининРуководитель продуктового развития, Yandex DataLens
Подключить LLM к базе — ещё не аналитика: агент не знает, откуда пришли данные, кто имеет к ним доступ и как посчитана метрика. Рассказываем, как встраивали ИИ в каждый шаг аналитического цикла (загрузку, SQL, оркестрацию, каталог, дашборды) и какой контекст ему для этого понадобился: автоматически собранные метаданные, lineage, права на уровне платформы. Разберём, где агент уже заменяет ручную работу, где ошибается и как проверить его ответ вплоть до исходной таблицы. Опыт DataLens Platform, самого крупного обновления DataLens: AI-first платформы, где к привычным дашбордам добавились lakehouse, оркестрация и каталог данных в едином интерфейсе
14:00 - 14:30Физика
Анна Ставнийчукк.э.н., научный сотрудник ЭФ МГУ, эксперт в сфере эконометрики причинно-следственных связей и экспериментальных методах
Тональность отзыва, тема обращения, категория товара — ещё недавно всё это размечали вручную, теперь же — размечают языковые модели. Вместе с этим изменился статус чисел, которые на такой разметке считают. Метрика в дашборде и целевая метрика эксперимента больше не наблюдаются – они предсказываются. Можно ли считать статистику по метрике, которую проставила модель, и что с этой статистикой не так?
15:15
15:15 - 16:00Молекула
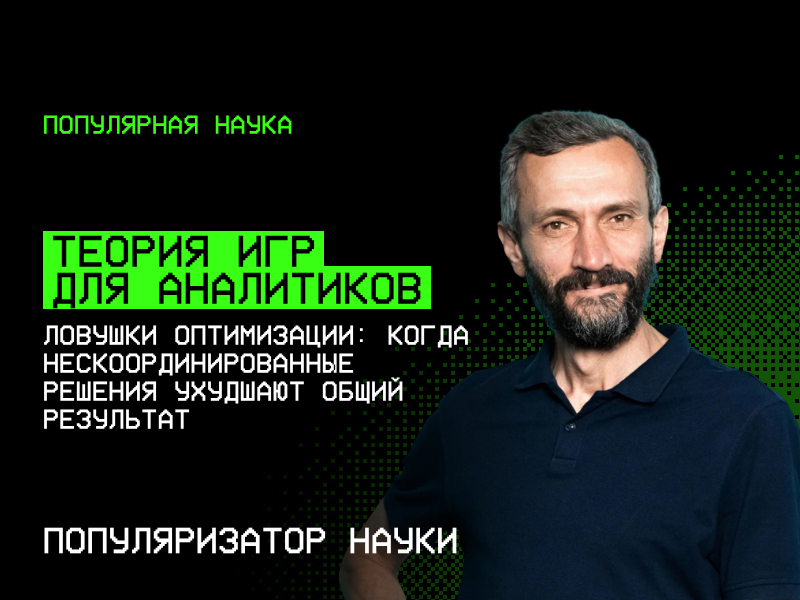
Алексей СавватеевРоссийский математик и специалист в математической экономике, популяризатор наук
Теория игр для аналитиков. В своей лекции, посвящённой теории игр, Алексей Савватеев доступно расскажет о концепции равновесия по Нэшу в теории игр и продемонстрирует на ряде примеров, как взаимодействие эгоистичных участников может приводить к общему проигрышу. Парадокс Брайеса, дилемма заключённых, трагедия общин — во всех этих ситуациях равновесная логика не гарантирует удовлетворительного результата с точки зрения глобальной пользы обществу. Особое внимание будет уделено тому, как изменение правил игр меняет поведениелюдей, что необходимо учитывать при конструировании мотивационных схем. Специальная математическая подготовка не потребуется,но готовность рассуждать пригодится.
15:15 - 16:00Атом
ДИСКУССИИАтом
Дискуссия руководителей аналитики крупных технологических компаний о будущем функции: какие задачи будут уходить, какие зоны ответственности появятся и как к этим изменениям готовить команды.
15:15 - 16:00Физика
ДИСКУССИИФизика
ЕФ
Евгений ФиногеевРуководитель направления AI переводов и внедрения ИИ в производственные процессы, RWB
ВД
Виктория ДочкинаДиректор Центра развития ИИ и исследования данных блока "Стратегия и развитие", Сбер
ПК
Павел КриворучкоДиректор департамента вертикали «Персонализация и обратная связь», х5
РБ
Роман БудылинРуководитель DS-команды, Авито Авто
Руководители AI/ML-команд поделятся практическим опытом, инженерными компромиссами и подходами, которые используют в работе
15:15 - 16:00Кинетика
Виталий ШатиловLead AI developer, ИТ-холдинг-Т1
Участники мастер-класс узнают о комплексном подходе к обеспечению базовых принципов информационной безопасности собственных продуктов. Будут рассмотрены в том числе автосканирование по публичным базам уязвимостей, собственные «зеркала» с уже проверенными пакетами и другие инструменты. Слушатели получат чек-лист критически важных моментов, на которые необходимо обращать внимание при разработке продуктов агентами. Мастер-класс сопровождается большим набором кейсов и примеров.
16:35
16:35 - 17:40Молекула
Без трекаМолекула
Подведение итогов, аналитика конференции, обсуждение новостей, планов на будущее, анонсы новых продуктов, благодарности и прочие важные приятные моменты. Во время закрытия состоится розыгрыш всех призов от Партнеров, стендистов и друзей конференции (участвуют только те, кто находится в зале)"
16:35 - 17:40Архангельск
ДИСКУССИИАрхангельск
ИГ
Ирина ГовороваРуководитель команды ML "Доверие и безопасность", Циан
МП
Михаил ПонеждаРуководитель направления Trust & Safety, Мамба
Представители крупных digital-продуктов поделятся реальными кейсами классификации и обогащения данных с помощью ML/LLM. Обсудим, как AI помогает автоматизировать бизнес-процессы в Trust & Safety, сокращать издержки и получать измеримый экономический эффект.
16:35 - 17:40Физика
ДИСКУССИИФизика
За год замеры видимости брендов в ответах нейросетей прошли путь от эксперимента до строки в медиаплане. Но единой методологии пока нет: агентства, вендоры и инхаус-команды по-разному определяют упоминание, формируют выборку промптов, выбирают число прогонов и оценивают устойчивость результатов.
17:45
17:45 - 19:00Молекула
Станислав ДробышевскийРоссийский палеоантрополог и популяризатор науки
Как наш мозг создал знания и как на него влияет искусственная информационная среда, когда AI меняет культурную среду быстрее, чем биологию человека.
17:45 - 19:00Физика
ДИСКУССИИФизика
Мы привыкли проверять гипотезы и доверять данным. Но что, если сегодня нужно угадать не точный ответ, а тот, который выбрало большинство? Угадываем популярные ответы, разбираемся в болях индустрии и проверяем, насколько наши представления о пользователях совпадают с реальностью. Только логика, интуиция и коллективный разум.