11:00 - 12:10 Молекула
Валерий Бабушкин Старший главный начальник, BP
Валерий Бабушкин, cтарший главный начальник BP.
Матемаркетинг 2026 · 26 ноября, чт
1 день программы: 39 докладов в 5 залах. Время указано по Москве; сетка повторяет страницу первоисточника, но собрана на билде.
Валерий Бабушкин, cтарший главный начальник BP.
Рабочие сценарии без подписки на Claude Code, Codex и другие передовые решения. Какие задачи разрешимы прямо сейчас на полностью открытом стеке, а где сохраняются ограничения. Эксперименты с Goose, Qwen и DeepSeek
Спикер поделится sql-кодом, который позволяет проверить честность модели атрибуции на собственных данных, а так же быстрым маркером некорректной оценки источников в one-touch моделях. Слушатели получат переиспользуемый аналитический фреймворк для быстрой оцифровки проблем с one-touch атрибуцией, которая искажает реальный вклад рекламных каналов в B2B-продуктах и сервисах с длинным циклом сделки.
Настройка обвязки и MCP-сервера для автоматизации рутины. Разбор ошибок масштабирования, эксплуатационные ограничения и задачи, где LLM категорически нельзя оставлять без проверки
Трансформация сырых голосовых логов в структурированные датасеты с помощью нейросетей. Строим автоматическую транскрибацию, тегирование намерений и распознавание эмоций, чтобы превратить речь в данные, пригодные для количественного анализа

Как всей компании пройти путь от «AI, помоги написать SQL» до «AI, возьми задачу целиком»? Расскажу, какие технические решения мы для этого собирали в нашем направлении в Яндексе и как связали их в одну систему. В моем рассказе мы разберём три драйвера роста использования AI: Adoption - чтобы люди начали пользоваться AI. Как убрать все преграды и сделать AI в привычным рабочим инструментом. Harness - чтобы агент использовал внутренние инструменты. Как дать предсказателю следующего токена возможность использовать утилиты, которыми пользуются люди и обучить необходимым навыкам, а потом еще и проверить результат. Knowledge - чтобы агент понимал контекст вашего бизнеса. Как дать агенту информацию о данных, коде, документацию компании, чтобы меньше объяснять с нуля и не забить все окно контекста. Покажу, как устроена эта экосистема: от интерфейсов для работы с агентами до тестирования документации. В финале соберём всё на примере типовой задачи аналитика и вы сможете примерить эту архитектуру на свою команду и понять, каких компонентов вам пока не хватает.

Расскажу, как мы организуем end-to-end автоматизацию типовых data-задач: как меняется работа подразделений с появлением агентов и как удалось достичь ускорения на 73% на задачах, выполненных агентами. Отдельно обсудим, как посчитать value от AI-агентов и на чём фокусироваться на уровне организации, чтобы двигаться вперед в агентизации типовых процессов работы с данными.

Рассказываем про работающий процесс в закрытом контуре государственного банка. Собрали единую базу знаний о клиентах из всех доступных источников. На её основе автоматически формируется портрет клиента, а по портрету готовится предложение, актуальное именно для него. Весь путь от сбора данных до готового предложения у менеджера автоматизирован. Ценность кейса в том, что это работающий процесс в закрытом контуре государственного банка, а не эксперимент. Как собрать портрет клиента, которого у банка ещё нет: какие источники дали пользу, а какие оказались шумом.
- Какие границы между профессиями теряют смысл, а какие становятся особенно важными? - Где брать опыт и как учиться на протяжении карьеры? - Что проверять без AI, а что — обязательно с AI? Где важно самостоятельное владение методом, а где — способность получить и проверить результат с инструментами? - Какие форматы оценки стоит менять? Что теперь могут показать экзамен, домашнее задание, тестовое, портфолио и техническое собеседование? - Как проверять понимание и перенос навыка? Достаточно ли попросить объяснить решение, найти ошибку или адаптировать подход к новым условиям? - Как оценивать работу с AI? Какие признаки отличают сильного пользователя от человека, который принимает убедительный ответ без проверки? - Как проверять квалификацию действующих сотрудников? Что должно подтверждать готовность к большей ответственности или переходу в соседнюю роль? - Во что специалисту инвестировать своё время уже сейчас?
Как пройти путь от сырых данных до ответа на вопрос о продукте — в одной платформе и с помощью ИИ? На мастер-классе разберём этот цикл на практическом примере: загрузим данные в Lakehouse, с помощью ИИ-агента подготовим SQL-запросы и настроим оркестрацию, организуем каталог данных и доступы, а затем соберём дашборд с Нейроаналитиком.
Восемь шагов от аналитической задачи до принятого ответа агента с проверкой на разных этапах: передаваемость определяется не сложностью задачи, а тем, объявлены ли решения; незаписанное решение всё равно будет принято — слоем, витриной или моделью; приёмка зависит от образа результата, и у самой приёмки есть слепая зона.

Опыт принятия сложных решений для арбитража внутреннего трафика и принятия решений для максимизации ROI экосистемы.
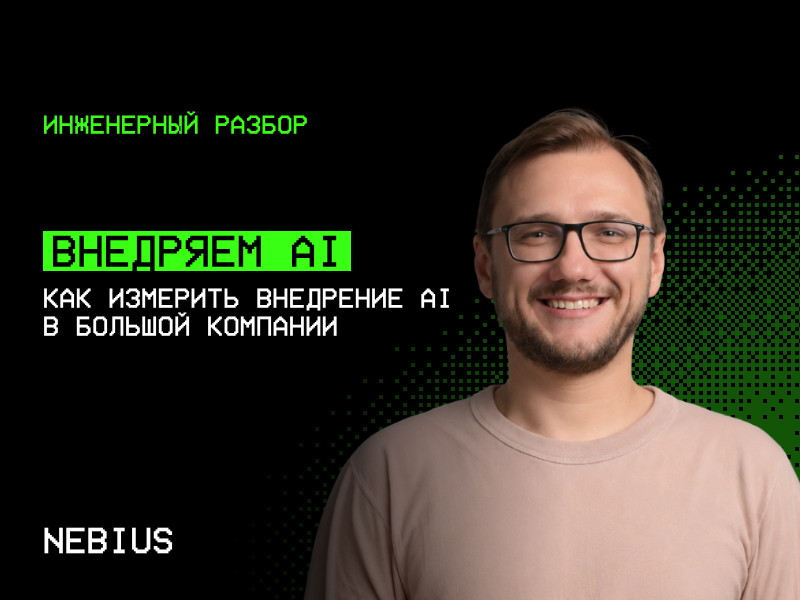
Системный подход к оценке AI Adoption внутри большой компании: от архитектуры решения до детального разбора применяемых методов. Слушатели получат фреймворк для оценки эффективности AI-инициатив, позволяющий управлять процессом внедрения нейросетей на основе данных.

Каким станет ближайшее будущее аналитиков, когда фабрики отчетов и инсайтов уже заслужили свою репутацию, аналитик перестал быть «узким горлышком», а объём контекста компании конечен для построения аналитической системы

Разбор рабочей системы реалтайм-атрибуции, которую мы спроектировали, довели до боевой нагрузки и измерили сами с цифрами на каждом шаге: от 11 строк/с на стейджинге до ~26 тыс. событий/с в проде, с бенчмарками четырёх баз данных и стоимостью в рублях за миллион событий. Слушатели унесут не список технологий, а проверяемые правила выбора. Покажем не только результаты, но и собственные ошибки методики измерений
С ростом команды пипл-менеджмент занимает всё больше времени и внимания руководителя. Найм, развитие сотрудников и организационные вопросы вытесняют проектный контекст — руководителю становится сложнее обсуждать задачи по существу и предлагать содержательные решения. Поговорим о том, как распределять ограниченное контекстное окно между людьми и проектами, какой уровень погружения действительно необходим и какие практики помогают сохранять понимание сути происходящего в команде. Ключевой тезис: ресурс руководителя ограничен не только временем, но и объёмом контекста, который он способен удерживать. Баланс между пипл-менеджментом и проектами достигается во многом за счёт управления собственным вниманием.
AI-агенты позволяют аналитикам и менеджерам за минуты создавать интерактивные HTML-отчёты — гибкие, но не всегда надёжные. На примерах разных бизнес-юнитов Яндекса сравним HTML и классические дашборды, а также покажем, как SDK помогает совместить гибкость с управляемостью BI.
Как превратить работу с LLM в устойчивый метод управления и оптимизировать процесс принятия управленческих решений

Кейсы обнаружения автоматизированного трафика и подходы к оценке качества фильтрации. многоуровневый анализ браузерного окружения, про отказ от блокировок по IP в пользу точечной фильтрации на уровне L7.

Поговорим о том, как сегодня добиться измеримого результата в областях где совсем недавно полагались "на веру", как выстроить AI-native фреймворк работы маркетинга и почему здесь нужна революция а не эволюция. Подробно расскажу о том, как выглядят конкретные примеры маркетинговых механизмов в Авито и поделюсь лайфхаками, которые приносят результаты.
Проверенная схема построения высоконагруженных пайплайнов для подготовки ML-датасетов, краулинга и ETL. Как закладывать бизнес-логику в модель данных, и почему отказ от потоковой агрегации глобальных состояний делает систему устойчивой
Честно разберём, что на самом деле ценят на собеседованиях и как выделиться среди других кандидатов. Поговорим о зарплатах, странных требованиях компаний и мэтче с будущей командой. Выясним, где лучше расти как специалист, где идти за деньгами и что важнее при выборе оффера: должность, интересные задачи, люди или зарплата.

Что мы делаем ценообразование на Авито более справедливым для селлера за счет оптимизации стоимости контакта.

Стандартные статистические тесты не работают для сложных продуктовых метрик (MAU, Retention, NPS, CTR) из-за их ratio-структуры и автокорреляции, а бутстрап требует слишком много времени. На воркшопе мы разберем создание полностью автономного пайплайна для оценки A/B-экспериментов на чистом SQL (Presto/Trino) без сторонних платформ. Участники получат готовый алгоритм и код: от настройки SRM-контроля и линеаризации метрик до расчета MDE с поправкой Бонферрони и получения итоговых p-value из сырых логов.
Главный результат аналитики выражается не точностью цифр, а тем, какие решения компания принимает на их основе. Что делать, когда привычные продуктовые метрики перестали отражать долгосрочное здоровье продукта, а разные команды по-разному понимают, что именно считать успехом? Вы узнаете, как изменить подход к измерению продукта и повлиять на реальные бизнес-решения
Превращаем data‑каталог из «реестра таблиц» во внутренний продукт уровня экосистемы, выстроить архитектурный каркас, а затем “зашить” в него логику, которая закрывает реальные пользовательские сценарии аналитиков, инженеров и владельцев данных.

Оценка трендов навыков продуктовых аналитиков на основе анализ мировой и российской научной повестки. Представлены семантические карты, тренды, драйверы развития и барьеры. Слушатели познакомятся с изменениями в профессии продуктового аналитика (как меняется спрос на навыки и компетенции и какая и как происходит перефокусировка).

Мы распарсили «черный ящик» диалогов селлера с ассистентом, даже не используя LLM-судей. Нам удалось полноценно выстроить воронки выполнения рекомендаций и выделить основные пользовательские сценарии использования ассистента и измерить качество AI-ассистента.

Трансформация вертикали data-аналитики в AI-native состояние. Слушатели узнают про «fast-track» для трансформации с целью радикального сокращение t2m-решения задач без потери в качестве. Подробно разберем целевую архитектура инфраструктуры для AI-native команды, компетенции, которые необходимы для успеха и то, как бороться с отторжением смены парадигмы командой
Контроль качества данных в bigtech-масштабе без ручной разметки и специфика подготовки медиа-источников. Архитектура пайплайна подготовки pretrain-корпуса и чеклист что отсекать, чтобы не сжигать дорогой compute на грязных данных

Как растить начинающих аналитиков, чтобы они быстрее становились самостоятельными, приносили пользу продукту и не теряли интерес к работе после испытательного срока. Поделюсь тем, как мы работаем с ошибками, вопросами, обратной связью и постепенно передаем ответственность. И поговорим о том, почему даже хорошо обученный джун может захотеть уйти

Превратили массовые CRM-пуши в систему, которая автоматически подстраивает объём и состав аудитории под баланс спроса и предложения на платформе подработки. Разбираем путь от расчёта сегментов и приоритизации пользователей до проверки решения A/B‑тестом. В результате пользователи стали получать в шесть раз меньше пушей без снижения числа бронирований смен.
Как агенты ведут Яндекс.Директ, генерируют контент и дизайн, строят аналитические дашборды и выполняют маркетинговые задачи по расписанию.

Путь от идеи до запуска готовой функциональности в продакшен можно объединить в единый процесс, управляемый AI-агентами? Мы расскажем, как создали продукт для сквозной автоматизации разработки: от поступления фич-реквеста и проработки требований до реализации, тестирования и публикации готового решения. Наглядно покажем, как именно AI-агенты взаимодействуют друг с другом, берут на себя задачи на разных этапах разработки и помогают управлять всем процессом в единой системе. На примере нашего решения разберём, как меняется привычный процесс разработки, какую роль в нём играет человек и как перейти от отдельных AI-инструментов к полноценной агентной автоматизации

Разбираем архитектуру агентной системы: контракт задачи, управление агентами, данные и инструменты, расчёты и проверки. Покажу, как передаются задача, результаты расчётов и статусы проверок, когда нужна доработка и где решение принимает человек. На наших кейсах разберу неоднозначные метрики, связь качества модели с бизнес-KPI и влияние дрейфа. Проверки охватят данные, применимость метода, обоснованность выводов и устойчивость рекомендаций к допущениям: правила и пересчёт, поиск противоречий агентом, разбор специалистом. Покажу, как планируем применять архитектуру в платформе экспериментов и Data Science Альфа-Банка

Кандидат, прекрасно продал себя на собеседовании, но выяснилось, что что-то не то и его необходимо уволить. Что делать, если HR не соглашаются увольнять по результатам срока испытания, но быть заложником ситуации тоже не хочется.

Кросс-категорийная монетизационная лента на главной - одна из самых денежных раскаток команды эффективности монетизации. Расскажу, как мы научились приводить качественный платный трафик с главной. Отдельно разберу главный урок для аналитики: почему в АБ-тестах, которые меняют ранжирование, поюзерный сплит завышает эффект на выручку в разы, как мы это отловили и измерили.
Разбор отраслевой практики создания и использования LLM. Спикер делится «лестницей опций» и прозрачной сметой каждого сценария: использование моделей по API, запуск открытой модели на собственной инфраструктуре, адаптация под отдельную задачу или домен, центральная модель компании, собственный претрейн и разработка frontier-модели. Разбираем какие потребности закрывает каждый сценарий и какие требования действительно оправдывают переход к более сложному решению. Из чего складывается каждая смета и метод фазирования, который позволяет покупать пошаговые проверки гипотез с точками принятия решений.
По этому треку в выбранный день докладов нет.
Ищет по всем трём дням: название, спикер, трек, зал.
Ничего не найдено.